CS285 课程笔记:课程回顾与开放问题
回顾 CS285 的整体知识框架,并讨论深度强化学习仍然面临的挑战与开放问题。
Review
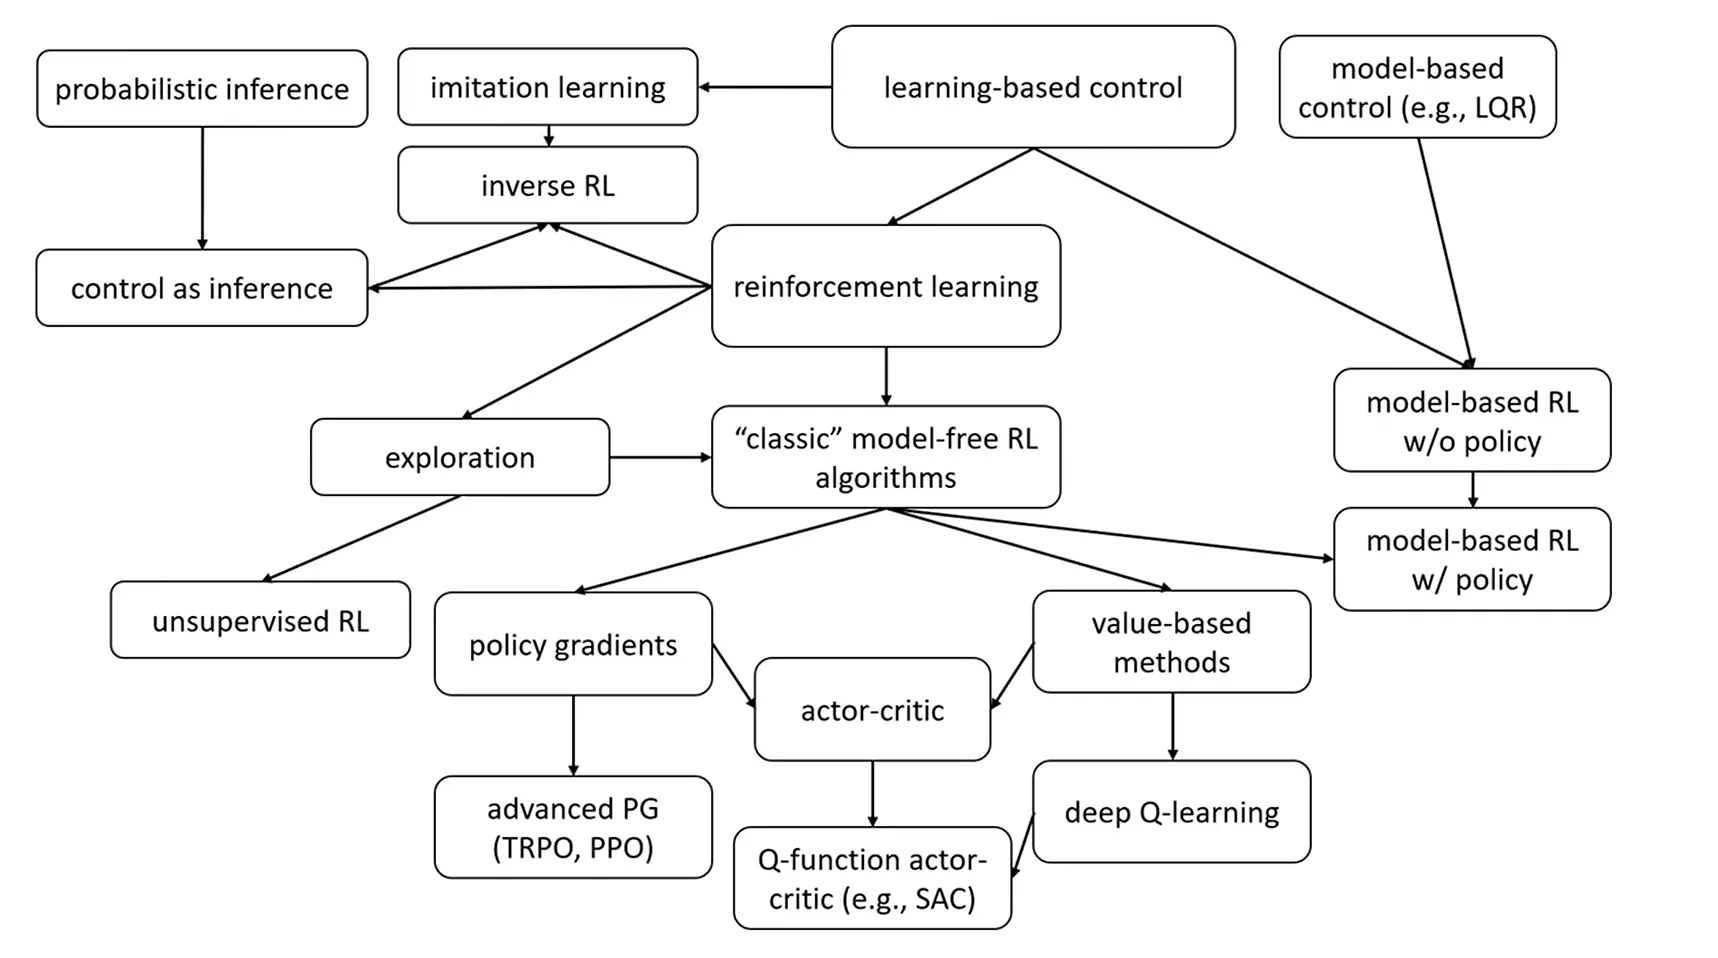 归根结底这门课主要是基于学习的控制方法,基于学习的方法包括模仿学习(从示范中学习)和强化学习(从奖励中学习)。强化学习包括经典的无模型强化学习,例如策略梯度和基于值的方法(如 Deep Q-learning),这两者结合产生了 Actor-Critic 算法。此外还有基于模型的控制,基于模型的控制不一定是基于学习的例如之前讨论过的规划和控制方法 LQR,它们不与学习直接相关,但是可以与学习的方法相结合产生基于模型的强化学习算法。
Challenges and Open problems
对 Deep RL 的挑战实际上是对核心算法的挑战,比如
- stability:算法能否收敛?是否需要非常仔细地调整超参数,还是同样的超参数可以适用于各种不同类型的问题?
- efficiency:收敛需要多少时间?需要多少样本或试验,以及可能需要多少计算资源?
- generalization:算法收敛后能否泛化到新的问题设置中?
解决 RL 问题时提出的假设也面临挑战,并在应用于现实世界时更加突出,比如
- RL 是否是这个问题正确的形式化方法?也许你想解决一个基于学习的控制问题但一些 RL 假设不完全适用,例如可能无法访问真实的 reward function。
- 这个现实世界问题的监督来源是什么?监督形式与告诉算法想要做什么有关,以及想要方法如何执行。
某种意义上强化学习解决的问题要比监督学习难得多,强化学习需要自己获取数据,不能假设数据是独立同分布,需要优化自己的目标而不是求一个最优解。这些额外的挑战使得强化学习对于参数如探索率、学习率等的设置更加敏感。
Stability
设计一个稳定的 RL 非常困难,这里的稳定指参数的微小变化不会导致性能的大幅下降。不同类型的方法在这里表现的各不相同,而这些挑战实际上都源于相同的核心问题,即必须在没有真实最优数据监督的情况下发现最优行为,通常需要收集自己的数据。
Q-learning/Value-based method 的部分问题在于用深度神经网络拟合值的方法通常不是压缩映射,因此大多数情况下不能保证收敛。虽然我们使用很多技巧可以使它们在实践中收敛,但这个理论问题依然存在并以多个方式体现。首先这意味着很多参数需要仔细选择以确保稳定性,如 target network delay,replay buffer size,clipping,learning rates 等。这些选择敏感的原因在于核心算法框架通常可能不收敛,而我们加入这些参数是为了使其收敛。现在人们也研究出一些方法使这些算法更稳定、易于使用,如使用大型网络、合适的归一化方法、使用数据增强等。其中一些得到了解释,也有一些更根本的未解之谜,例如我们仍然不明白为什么监督式深度学习如此有效,传统机器学习理论认为监督式深度学习会导致严重的过拟合,因为模型参数远多于数据。经典深度学习之所以没有出现严重的过拟合,是大型神经网络和梯度下降算法产生了某种正则化效应使得这个问题不那么严重。监督式深度学习的这种神奇机制是否也适用于基于值的方法仍是一个开放问题。
Policy gradient method 的特点在于有更高的方差,但通常没有其他所有强化学习方法都存在的来自函数近似的偏差。一旦开始使用价值函数作为优势估计的 critic 也会引入同样的偏差,但在最纯粹的形式中它们就是具有高方差而没有偏差。高方差意味着需要大量的样本,这也可能导致严重的问题,在最坏的情况下方差的增长是指数级的。为了应对这一挑战,参数如 batch size、learning rate、baseline 的选择就非常关键了。
Model-based method 比较有意思,表面看起来是特别方便稳定的选择,因为模型学习过程最终归结为普通监督学习问题。然而基于模型的强化学习方法仍然是一个迭代的过程,意味着训练过程中模型会不断更新并且仍然要收集自己的数据。模型类型和模型拟合数据的方法都特别敏感,因为更精确的模型不一定能直接转化为更好的策略。更微妙的问题是策略可能会利用模型,即使大多数时候模型都表现良好,策略也可能找到方法执行某个错误的动作,却错误地预测会表现良好。某种意义上说,基于模型的强化学习是一种对抗过程。
Efficiency
效率最低、需要最多样本的方法是无梯度方法,这门课程实际上没有提到过这些方法,它们实际上完全不使用神经网络中的梯度。
效率更高的方法是完全在线 on-policy method 如 A2C,A3C,这些方法使用同策略运行并使用中心策略梯度更新,基本上不存储任何试验数据只在收集数据时更新。
然后是效率再高一点的策略梯度方法如 TRPO,收集一批数据并进行批量更新。
使用 replay buffer 的值估计方法用 off-policy learning 将效率提升一大步,如 Q-learning、DDPG、SAC 等。
接着是基于模型的方法,如 PETS、guided policy search,然后是基于浅层模型的方法,这些方法最高效但也最有局限性。像 PLICO 的浅层方法速度可以很快,在几秒钟内完成学习,但是需要使用像高斯过程这样不可扩展的模型,对高维系统而言根本不切实际。
在实践中我们可能更倾向效率低的方法,原因在于像 policy gradient 这样的方法通常更容易并行执行,如果可以并行模拟实际上的运行时间会更快。并且成本不止有样本成本,还有与环境交互的成本,计算成本。基于模型的方法通常最耗计算资源,出于这个原因可能会选择效率较低但计算量小的方法。
Scaling up deep RL
扩展泛化能力是 deep RL 面临的主要挑战,
一方面强化学习的优势在于他们能够发现新的解决方案,所以我们不希望对于它们进行过于严格的监督,但同时,如果监督目标过于高层,这就会变成一个很难的问题,所以我们必须要找到合适的平衡。在某些情况下,我们需要重新思考问题的表述方式,
-
数据是什么?在某些 case 下指明控制问题使用现实世界可能发生的数据比使用模拟或交互来定义问题会更容易,离线强化学习支持这种设置,而在线强化学习不支持。
-
目标是什么?由奖励、演示还是偏好来指定?
-
监督是什么?与目标相同吗,有时我们希望为 agent 提供一些提示来帮助他们学习同时又不影响他们找到的解决方案。
我们需要去思考适合自己问题设置的假设,有时正确的做法是把问题简化为标准的强化学习假设,但有时正确的做法是提出一个新问题,不要认为基本的强化学习问题是不变的,要不断思考调整以适应具体情况。
what deep RL actually is
强化学习实际上可以从几个截然不同的角度来理解,根据你对强化学习的理解,其中某些方法可能比其他方法更适合你。下面将讨论三种视角,当然肯定不止三种。
第一种视角认为强化学习是工程工具
第二种视角认为强化学习是 AI agent 在现实世界发现行为的一种方式
第三种视角(也是 Sergy Levine 最喜欢的一种,“因为我是一名 RL reasercher,所以我会采用最 RL 为中心的视角。”)认为强化学习是真正最通用、最基本的学习框架,涵盖了所有其他学习框架。
RL as an engineering tool
我们认为 RL 是一个与世界交互的模型,通过类似动物的奖惩机制学习,拥有非常自然贴近现实世界的学习过程。抛开这些我们先来看一些基础工程问题,比如你想发射一枚火箭并以最优轨迹飞行。传统上这并不是与强化学习相关联的问题类型,它设计大量复杂微积分和一堆描述火箭物理特性的方程,通过解这些方程我们可用知道火箭在每个时刻的位置,进而设计一个反馈控制器来控制火箭飞行。但从另一个角度看,如果我们把传统的控制问题看成是逆物理问题,那么强化学习就提供了另一种工具来实现这一点。这里逆物理指首先推导出物理模型,然后反转这个物理过程以确定能达到预期边界条件或结果的控制因素。在刚才这个火箭飞行过程中,就是有人理解了系统随时间演变的规律并用方程描述这个过程才得以实现控制。这其实与我们模拟某个东西非常相似,想象一个相对独立的系统,写下一堆方程然后通过数值积分计算出某个复杂系统如何随时间演变。因此如果我们在模拟器中运行强化学习,本质上我们是在利用机器学习来反转我们的物理模型。不是与外部世界交互,而是与我们自身对物理的理解交互。这里 RL 扮演一个逆向引擎,把模拟器转化为控制律,主要的缺点是仍然需要有人对系统进行表征。从这个角度来看,这几乎算不上一个学习过程,更像是一个非常强大的优化工具。
Real world learning
真正让现实世界如此艰难的,是我们会遇到各种意想不到的情况的变化性和多样性。为了设计一个能够应对意外情况的系统,我们可以用 RL 作为一个进入不确定世界的即时学习框架,体验发生的一切,从顺利或不顺利的事情中获得反馈并进行调整。
我们希望 agent 能够提出预期之外的令人兴奋的解决方案,这意味着训练 agent 的这个世界需要足够复杂。为了看见有趣的涌现行为,我们必须在真正需要涌现行为的环境中训练 agent。所以如果只是像工程方法那样只能使用模拟,那么 agent 就没有空间去发现过于不同的东西,只能发现我们设计的模拟世界范围内的东西。如果我们能够构建现实世界学习系统,它们或许就能发现有趣的新解决方案并拥有适应性和灵活性,从而解决 Moravec 悖论。
RL as universal learning
强化学习的真正力量可能在于它是更通用的学习框架,它不仅仅是我们学习与世界交互或解决控制问题的一种方式,它最终或许会涵盖所有的机器学习。
强化学习能为我们提供一种更好的数据利用方式,从而做出更优的决策。因为借助强化学习,我们从所有可能来源抓取的这类杂乱数据,实际上告诉我们的是现实世界可能会发生的事情。我们从过去交互获得的大量数据不一定是用来学习复制的,而是用来理解各种可能性,并在这些可能性中选择最能高效完成我们想要完成的任务的方案。
但问题在于因为要与世界交互来收集数据,朴素 Online RL 的成本很高,相比之下,自监督学习可以从大量无需人工标注的数据中学习表征或预测模型,而 Offline RL 则可以利用已经收集的交互数据学习策略,减少针对每个新任务重新探索的需求。从宏观层面来看,recipe 可能是收集大量多样但低质量的数据,运行某种强化学习过程如
-
Human-defined Skills 由人工定义技能目标或奖励,例如开抽屉、抓取,
-
Goal-conditioned RL 用历史中达到的状态自动构造目标来学习达到不同目标的通用策略,
-
Self-supervised Skill Discovery 通过状态可区分性、互信息或覆盖度等内在目标发现行为,学习不同、可复用的行为模式。
先探索如何实现各种结果,最后将其专门化,在少量的监督下找到如何实现人类实际想要的结果。
big picture
假设学习是智能的基础,那么 RL 使我们能进行决策推理,而深度部分使我们的算法能够学习复杂的输入输出映射,因此深度模型使得强化学习能够端到端地解决复杂问题。
一个观点:通过每个数据点获得的监督信息量来表征不同学习问题的有效性。例如学习一个图像分类器,假设有1000个类别,实际上为每个数据点获得了10 bit 的监督信息。如果进行自监督学习,预测视频中的下一帧图像,像素数量非常庞大,因此会有大量监督信息。如果进行强化学习,可能从相当稀疏的奖励中学习,获得的监督信息并不多。这引出的一个结论是从根本上来说,应该采用无监督学习方法利用大量数据,并以强化学习为机制来调整模型完成特定任务。还有其他观点认为,也许许多信号应该来自模仿或学习其他智能体,如果人离开社会长大可能就没有那么聪明,模仿可能才是通用人工智能远景的核心。
Sergy Levine 自己认为非常合理且站得住脚的观点:强化学习或许就足够了,因为即使在强化学习中你学习的奖励信号特别稀疏,但是奖励信号会受到非常复杂系统动力学的调节。因此像价值函数这样的实际监督,远比预测奖励是 1/0 复杂得多。一旦系统动力学和奖励信号相互作用,它就会以非常复杂的方式进行调节,而且你总是能运行多任务学习和其他方法获得更多的监督。也可能答案是上述的总和。
-
如何选择合适的问题,看它是否有可能解决一些真正重要的问题?我们要研究那些成功上限很高的问题,既考虑更宏观的哲学理念,但也要尝试将其简化为具体、可执行、可证伪的假设。
-
面对不确定性要保持乐观,这不仅适用于探索被搁置的问题,也适用于研究本身。
-
不要害怕改变问题陈述,许多挑战可以通过迭代现有的基准来解决。也许经典强化学习的基本假设不足以回答这些问题,我们需要做出一些改变,That‘s okay
-
应用很重要,将方法用于真实且有挑战性的现实世界可以让我们了解许多缺失的重要信息。我们需要认真对待这些信息,因此不要害怕研究更具有应用性的问题,它可能会揭示哪些问题更重要,哪些解决方案更有希望。
-
RL 长期以来忽视了这一点,专注于过度简单的问题,不要重蹈覆辙。
-
最后 Think big but start small,思考什么才能帮助我们开发真正强大的 ai 系统,完成那些以前从未有人想过的事。同时从清晰可操作的目标开始,以便衡量我们朝着成功迈出的步伐。