CS285 课程笔记:从模仿学习入门 DRL
主要探讨模仿学习的理论瓶颈、多模态连续动作表示,以及强化学习算法的基本结构与数学直觉。
前言
之前已经学过了CS188,打算加强一下深度强化学习的基础,于是开始学习 CS285: Deep Reinforcement Learning 深度强化学习领域名课,由 Sergey Levine 教授主讲,内容紧贴学术和应用前沿,涵盖策略梯度、Q学习、模型预测控制及机器人控制等核心现代算法。
WHY DRL
首先如果我们想要去构建一个系统,输入图像或其他信息让机器人去抓取一些东西,我们通常有两种方法,一是理解分析问题的约束和条件,设计流程、建模方程和解决方案;二是机器学习,通过监督优化最终直接端到端的生成抓取动作,但是在机器人领域我们并没有像LLM所拥有的web-scale的数据,所以强化学习成为一种重要选择,让机器人在环境中不断试验,与环境交互获得反馈,在闭环中不断迭代优化自己的算法。具体而言,就是在任务成功或失败后,获得一个正向或负向的激励,然后调整以某种启发式方法设置的与动作或状态相关的值,来改正当前策略的行为以最大化预期效益。而DRL 则是将现代大规模优化和计算与传统强化学习思想和基础相结合的概念。
课程结构
直接截取自课程视频
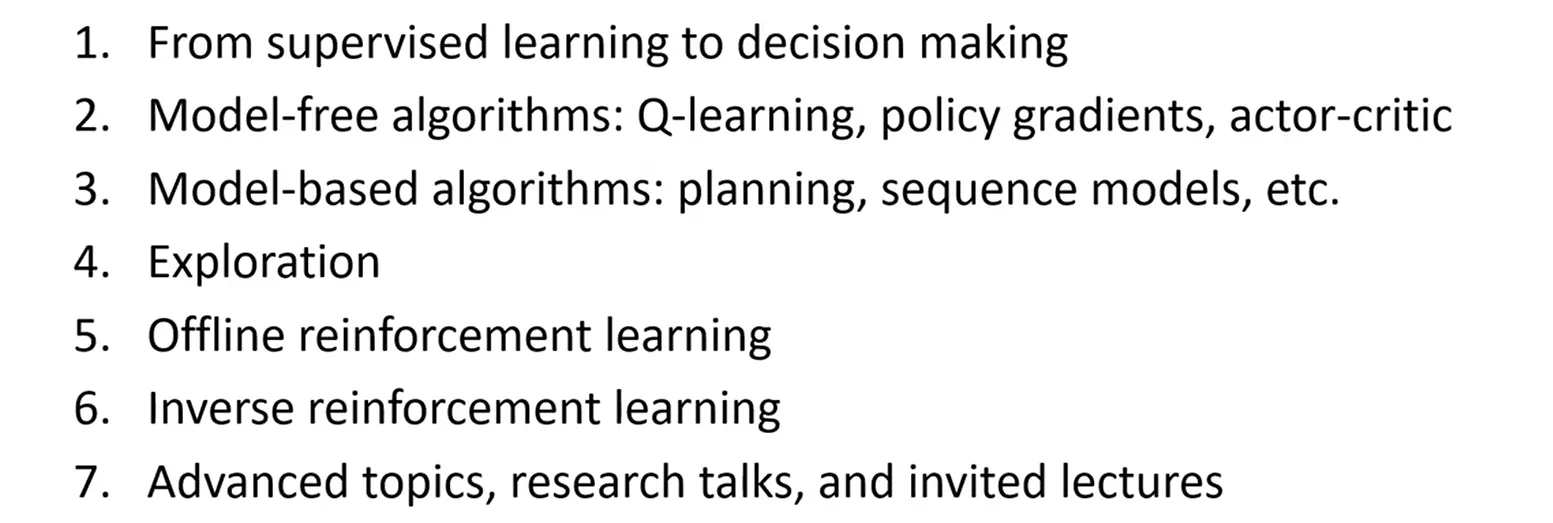
为什么我们需要机器学习
我们为什么需要大脑,脑科学专家Daniel 认为是为了产生适应性强的复杂的运动,类似的,我们需要机器学习是为了去产生适应性强的复杂的决策。
模仿学习
解决时序决策问题的一类方法,通过观察专家的演示数据,学习一个策略 π(a∣s)(即在状态 s 下采取动作 a),使智能体的表现逼近专家。其中最简单的一种方法是行为克隆(BC),直接将模仿学习简化为了监督学习,但是通过行为克隆进行模仿学习并不能保证成功。因为此时监督学习的独立同分布假设不再成立,在模仿学习中当前采取的动作 a 会直接改变环境状态,从而决定下一个输入状态 st+1,而训练数据中可能并没有这个状态,导致预测出现误差并不断累积最后越偏越远。
in theory
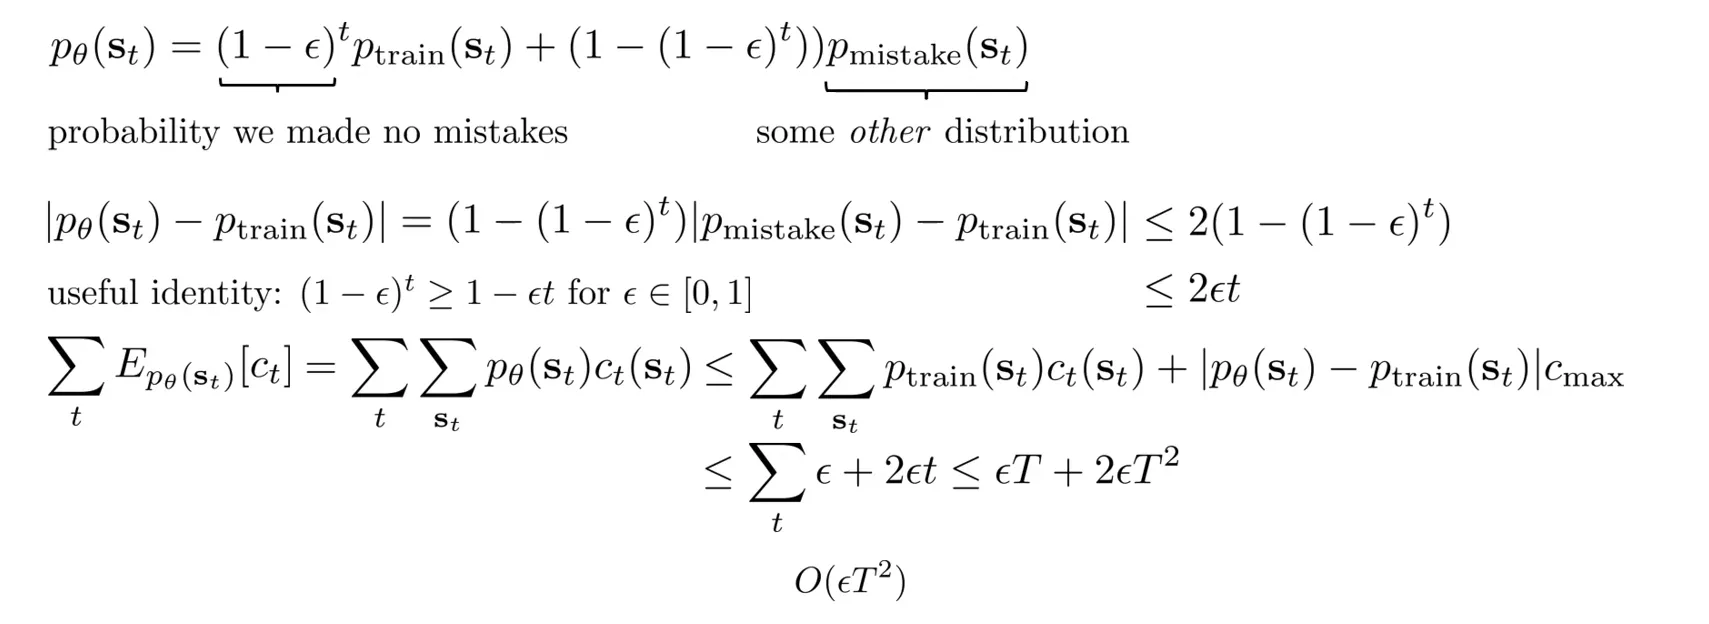
假设我们训练好了一个模型 πθ,它在专家跑过的标准训练轨迹上,单步犯错的概率最多为 ϵ。当机器人运行到第 t 个时间步时,它所处的空间状态分布 pθ(st) 有两种可能: 前面 t 步里,机器人一次错误都没犯过;前面 t 步里,机器人至少犯了一次错。此时,机器人已经偏离轨道,其状态滑向了某种错误分布 pmistake(st) 。计算此时状态分布与专家的真实状态分布之间的绝对差值(L1 距离),因为两个概率分布的L1距离最多为 2(等价地,全变差距离最多为 1),所以利用数学不等式进行放缩简化,可以得到 ≤2ϵt。假设犯一次错的惩罚代价是 1,在每一时刻 t 的预期代价等于走在轨道上的正常犯错率 ϵ加上 因为偏离轨道而产生的额外惩罚 2ϵt,对时间 t(从 1 累加到 T)进行求和结果为 O(ϵT2) 数量级。因为行为克隆(时序决策)前一步犯的错会影响下一步的输入,导致误差像滚雪球一样不断累积。
rather pessimistic
事实上BC 在实践中是有效可行的,现在仍然有很多人推崇 BC,只要我们能通过一些方法让模型能够学会从错误的状态进行调整、纠正错误、回到正轨或者更进一步理解应该做什么而不只是模仿。
几种应对方法
- 改进数据收集与增强数据的覆盖范围。
- 使用极高性能的模型,减少单次预测犯错的概率。
- 多任务学习,增强模型的泛化表征能力。
- 改变算法(如 DAgger 算法,收集跑偏后的数据重新标注再次训练)
为什么我们可能 fail to fit expert?
- 非马尔科夫行为:专家不一定仅基于当前状态来选择行动,人类通常会根据过去看到的所有事物来做决定,这时我们也可以加上历史,使用LSTM或transformer等。但是利用历史数据并不一定会有更好的效果,原因在于他可能会加剧数据中存在的相关性,但其实这种相关性不具有因果。
- 多模态行为:行为分布可能非常复杂,有多种模态,有两种解决方法:采用更有表现力的连续分布、高维动作空间中的离散化方法。
expressive continuous distribution
- mixture of Gaussians
可描述为均值、协方差、权重的集合,将多个高斯分布加权组合来拟合多模态分布,但是不太适合极高维的动作空间。
-
latent variable models
引入一个低维的随机噪声向量 ξ(通常符合标准正态分布 N(0,I))作为额外的自变量,来表达极其复杂的非线性分布 。在模仿学习中,最常用的是条件变分自编码器(Conditional VAE)。
-
diffusion model
不直接一步输出动作,而是从纯噪声出发,通过多次迭代“去噪”来生成干净的动作。
Autoregeressive discretization
它不假设任何高斯公式,离散化用直方图输出动作,但是直接对高维空间离散化是不切实际的,解决方法是每次离散一个维度。比如将本来需要输出 10×10×10=1000个通道的联合预测,通过概率论的链式法则和自回归序列模型,拆解为了 3 步、每步只输出 10 个通道的预测,符合动作维度之间极强的上下文逻辑绑定,成为很多前沿具身模型底层的动作生成基石。
Goal-conditioned Behavioral Cloning
多任务学习在机器人领域一种常用的数学实现形式
在目标条件行为克隆中,策略的网络输入由两部分组成:当前状态 s 和 目标状态 g。由于输入变成了两个,分布偏移(Distributional Shift)也会在两个维度上同时发生。第一个分布偏移:状态分布偏移,测试时的状态分布不等于训练时的状态分布;第二个分布偏移:目标分布偏移,在测试时给定的目标 g 可能是全新的,或者处于训练时未覆盖到的目标空间分布中。 由于第一个分布偏移,机器人现在已经偏离了轨道,身处一个错误的状态 st。即使此时要去的终点目标 g 是训练集里见过的,但“如何从当前这个偏离轨道的错误状态 st 去往目标 g” 的这种相对导航关系,在训练集(只包含完美的、从正确路径去往目标的数据)中是完全没有被训练过的。
DAgger 算法
- Dataset Aggregation,一种有效缓解分布偏移问题的方法。
使用演示数据训练策略,然后运行策略记录观测结果,请人查看观测结果并标注应采取的动作,将原数据集和新数据集合并回到第一步的训练,最终数据集中的观测分布会接近实际运行时的观测分布。存在的问题是有时离线获得的人类标准并不准确,许多对DAgger的改进旨在缓解这一点。
模仿学习为什么还不够
- 深度学习需要大量数据来获得一个较好的表现,而人类缺乏这种大量的可用于训练的动作相关数据,同时也并不擅长提供许多类型的机器人动作数据。
- 基于控制的学习中最让人兴奋的事是 emerging behaviours,我们希望能实现机器的自主学习和不断的自我改进 。
RL Intro
当我们没有任何数据的时候,我们怎么知道动作的好坏。这时我们就需要一个 reward function,奖励函数本质上是一个取决于动作和状态的标量函数,关键的一点是强化学习的目标不仅仅是采取当前高奖励的行动,而是未来最终带来更高奖励的行动。很多马尔可夫过程等强化学习相关概念在CS188已有提及,在这里不再记录。
在强化学习中我们始终关注的是期望值,即使期望函数本身高度不连续,期望值也可以关于相应分布的参数连续,这也就是为什么强化学习算法可以使用梯度下降等平滑的优化方法。在光滑且可微的概率分布下,非光滑且不可微的函数的期望值仍可能对分布参数可微。
强化学习算法的构造基本由三部分组成:
-
运行策略生成样本 智能体在真实或虚拟环境中运行当前的策略 πθ,通过与环境交互收集轨迹数据(包括状态s、动作a、即时奖励 r和下一个状态 s′),并将数据存入缓存(如 Replay Buffer)。
-
拟合模型或估计回报 利用第一步收集到的数据,要么去学习环境的运行规律(拟合动力学模型),要么去评估在不同状态下能拿到的长期回报(估计价值函数
Q或V)。 -
改进策略 利用第二步评估出的“好坏标准”或学到的“环境模型”,去更新和改进策略参数
θ,让智能体在未来更倾向于选择那些能带来高回报的动作。
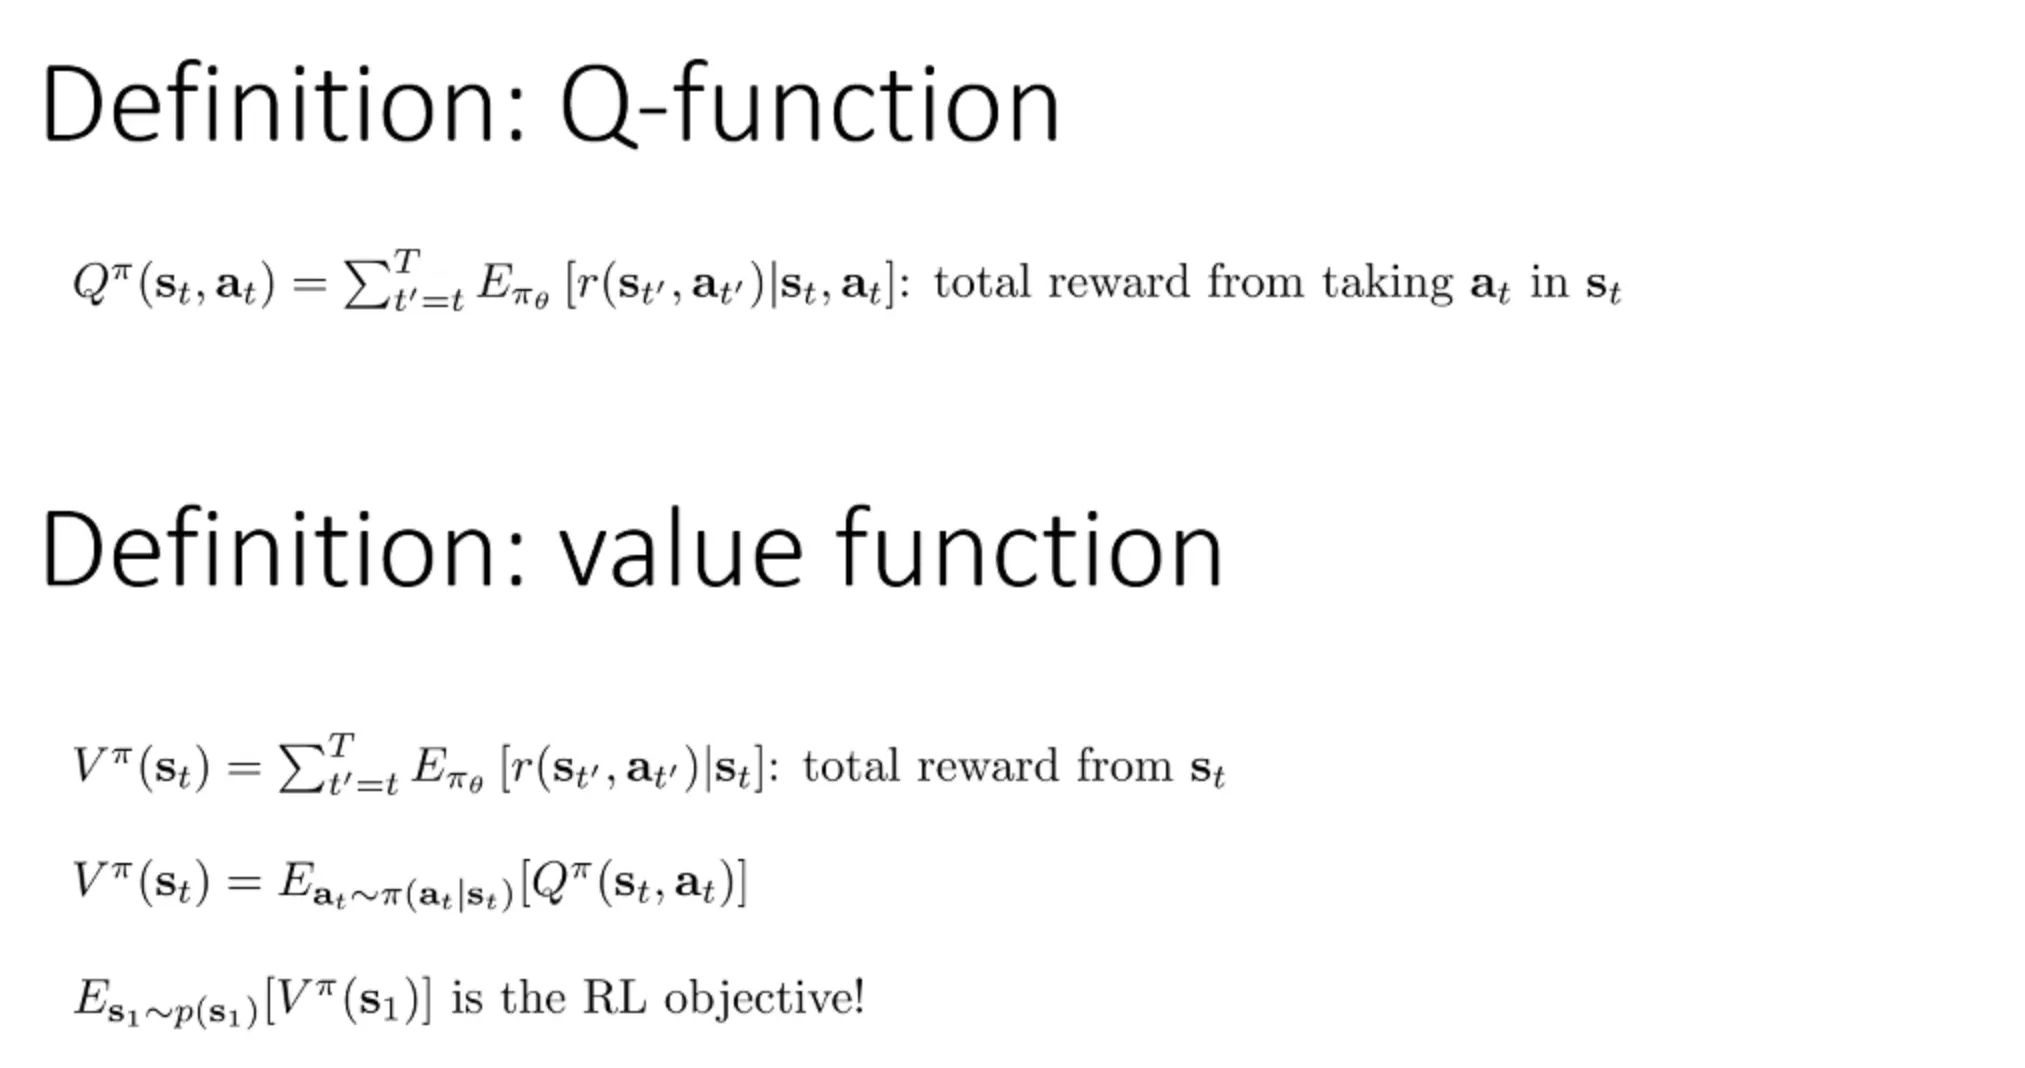
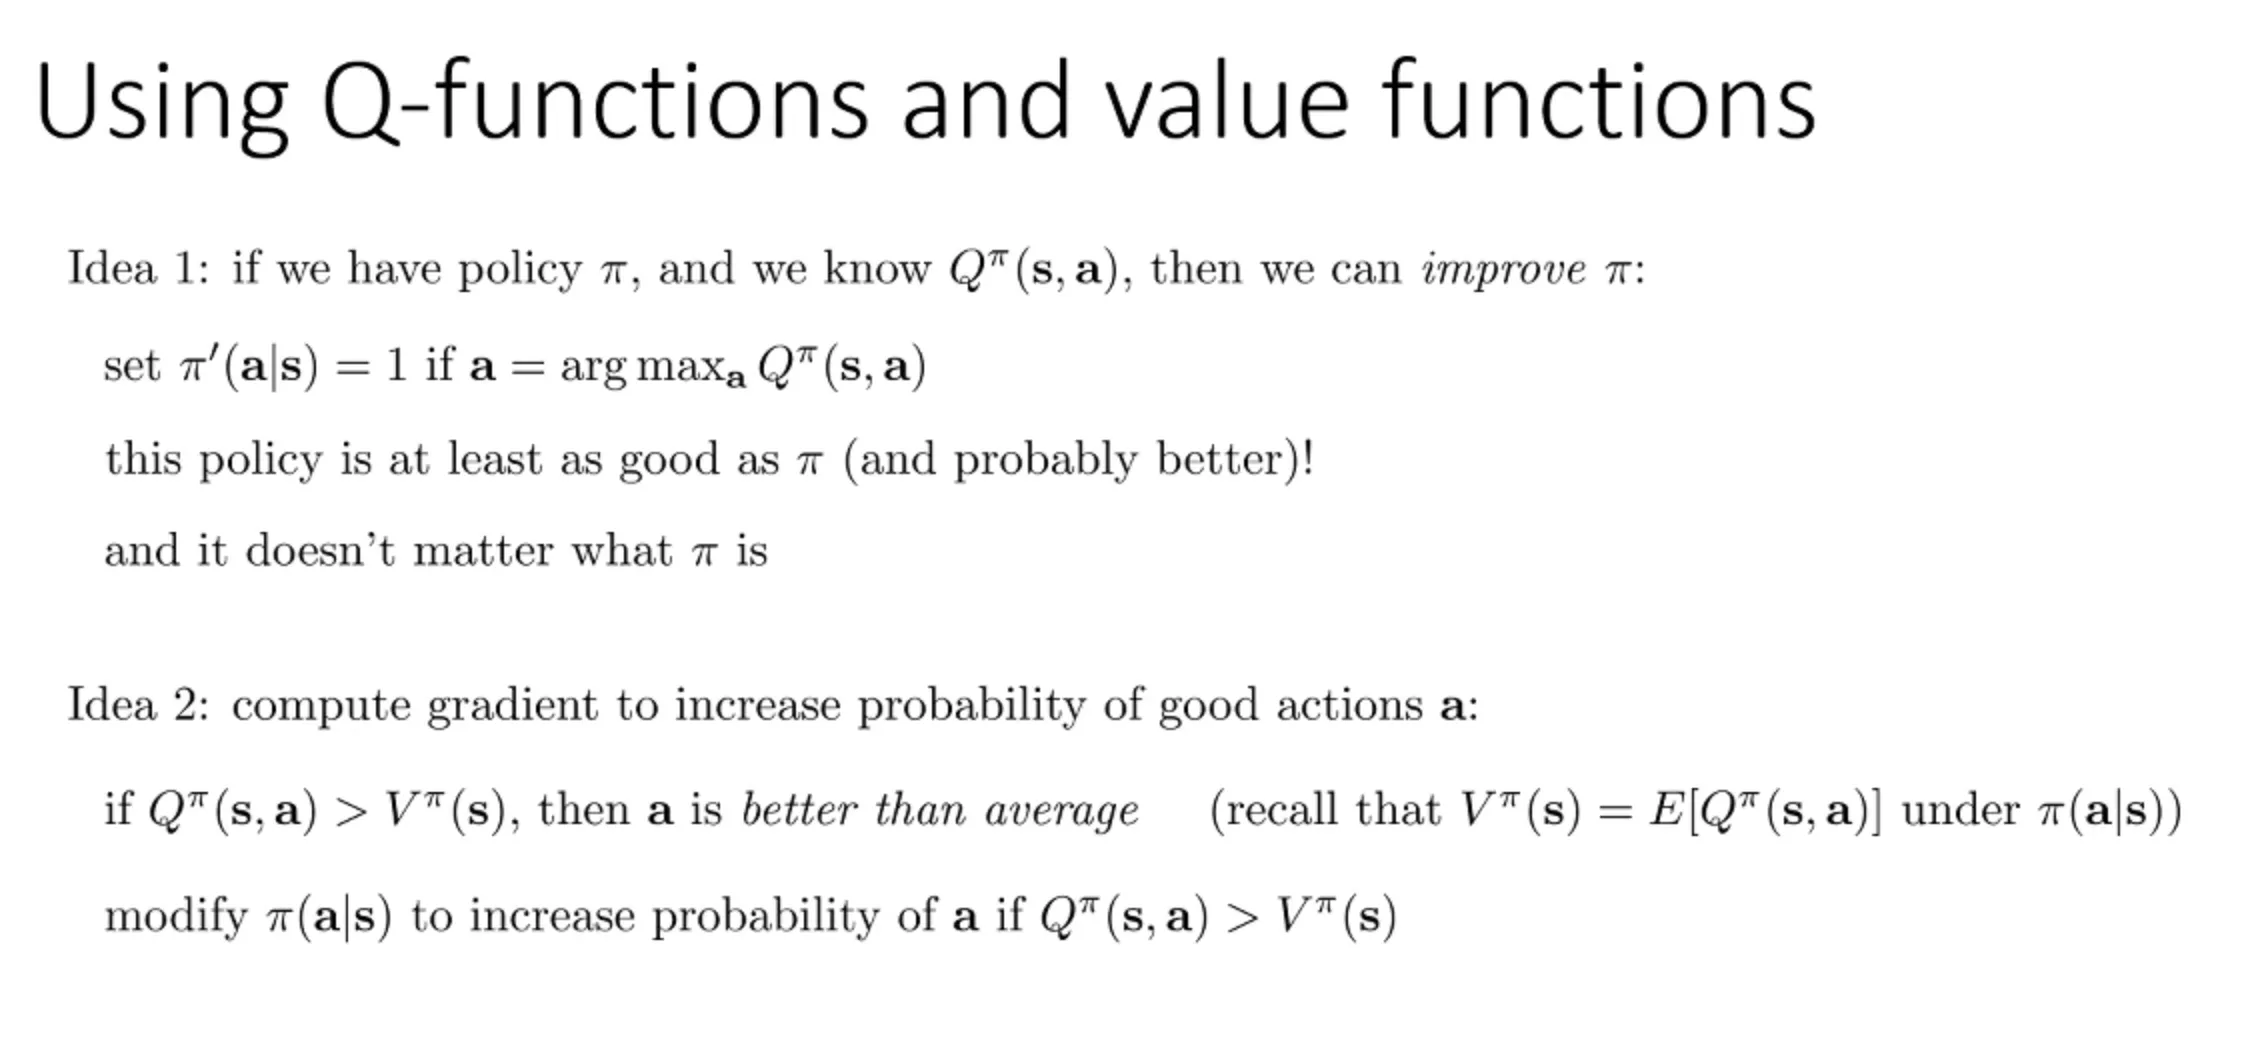
hw1
一个概率论结论
在离散概率分布中,两分布之间的 L1 距离(即绝对差值之和)恰好等于它们的全变差距离(Total Variation Distance,简称 TV 距离)的两倍。全变差距离是指两个概率分布在所有可能发生的事件集合(子集 )上,所能达到的最大概率差值总和:
几个注意事项
-
2024 年,NumPy 官方发布了全新的 NumPy 2.0.x 版本,重新设计了底层的二进制接口(ABI),导致它与之前的 NumPy 1.x 部分旧二进制扩展不兼容。如果虚拟环境中,很多库(比如 opencv-python / cv2 或者是 OpenAI 的 gym 库)是在旧的 NumPy 1.x 时代编译生成的。那么运行代码时,这些库检测到环境里当前装的是全新的 NumPy 2.0,由于底层接口对不上,程序会发生严重崩溃,并抛出这句经典的报错:
RuntimeError: module compiled against ABI version 0x1000009 but this version of numpy is 0x2000000(即模块是针对 1.x 编译的,但当前的 NumPy 却是 2.x) -
PyTorch 的标准数值层通常要求输入为 Tensor,把
numpy.ndarray直接传入Linear等层通常会触发类型错误,但nn.Module.forward本身可以接受字典、元组等任意 Python 对象。可以在 forward 函数内部加上一行类型判断,如果传入的 observation 是一个普通的 numpy.ndarray(NumPy 数组) 自动将其转换为正确的 PyTorch 张量:import numpy as np from cs285.infrastructure import pytorch_util as ptu def forward(self, observation: torch.FloatTensor) -> Any: # 如果是 numpy 数组,自动转换为 tensor if isinstance(observation, np.ndarray): observation = ptu.from_numpy(observation) return distributions.Normal(self.mean_net(observation), self.logstd.exp())