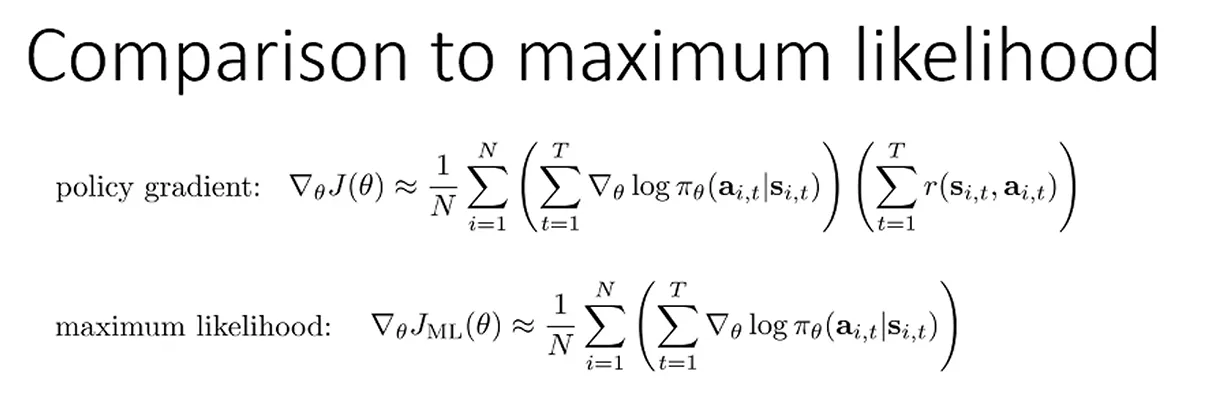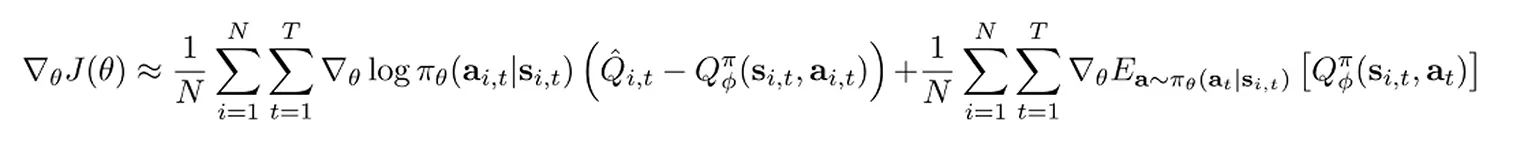前言
今天正式开始 CS285: Deep Reinforcement Learning 深度强化学习的第一部分 model-free 算法,包括 policy gradients、actor-critic、Q-learining。
Policy Gradients
最大似然中梯度只是把所有动作的对数概率简单相加,而策略梯度则会根据轨迹的奖励值增加或减少对数概率,可以理解为对最大似然梯度的一种加权版本。
probelm
策略梯度的方差很大,对于任意有限的样本,最终得到的策略梯度值都很可能不同。这意味着在实践中,为了使梯度策略成为强化学习的有效工具,我们需要以某种方式降低这种极高的方差。
reduce variance
一个利用 causality 关系的 trick是reward不再是所有时间的总和而是时刻 t 状态从时间 t 到T的总和,因为时间步t的动作不能影响过去的奖励,这意味着在无限样本量下当下状态各种可能的策略梯度必然会抵消,时间步t以前的策略梯度的期望为0,不会影响当前时间步的概率。舍去所有过去的奖励,对于有限量的样本其实并不会抵消,实际上会改变估计量,但仍然是无偏的。通过从求和中移除一些量,得到了一个方差更低的估计量。
baseline
从策略梯度的奖励中减去一个常数b,对于无限样本量下不会改变梯度的期望,但是会改变方差。一种baseline是取平均值,增加高于平均值的轨迹的概率,降低差于平均值的轨迹的概率,减去这个基线仍保持无偏,平均值不是最好的baseline在实际中也不常用,但方便帮助我们去理解其他变体。
auto differentiation
在深度学习中,我们习惯先定义一个损失函数(如 MSE 或交叉熵)然后求导,但策略梯度的目标是最大化期望回报 J ( θ ) J(\theta) J ( θ ) log_softmax 中选出对应动作的对数概率。
import torch import torch . nn . functional as F # 1. 策略网络输出动作的 Logits(形状:(N*T) x Da) logits = policy ( states ) # 2. 计算负对数似然 negative_likelihoods = F . cross_entropy ( logits , actions , reduction = ' none ' ) # 3. 乘以 Q 值进行加权。q_values 必须通过 .detach() 阻断梯度,防止自动微分对其求导 weighted_negative_likelihoods = negative_likelihoods * q_values . detach () # 4. 计算均值,得到最终的“伪损失” loss = torch . mean ( weighted_negative_likelihoods ) # 5. 反向传播,计算策略梯度 optimizer . zero_grad () loss . backward () optimizer . step () 另一种使用 torch.distributions,以离散动作的 Categorical 为例,连续动作可使用 Normal 等分布:
import torch import torch . distributions as distributions # 1. 网络输出 Logits 并组装成分类分布 logits = policy ( states ) action_dist = distributions . Categorical ( logits = logits ) # 2. 直接计算对数概率。 # log_prob(actions) 计算的是 log π(a|s) log_prob = action_dist . log_prob ( actions ) # 3. 构造伪损失(加上负号转化为梯度下降,并乘以 Q 值) loss = - (log_prob * q_values . detach () ) . mean () # 4. 自动微分求导 optimizer . zero_grad () loss . backward () optimizer . step () in practice
策略梯度估算噪声大有着极高的方差,所以习惯用比监督学习更大的批次如5000、10000等,同时在调整学习率上也有更大的难度,像 Adam 这种自适应步长算法也只能算勉强。后续将谈到专门针对策略梯度的学习率调整方法(如自然策略梯度)总的来说需要比通常在监督学习中更多的超参数调优。
Natural PG
普通的策略梯度更新相当于在解下面这个受限优化问题,只限制了新旧参数在参数空间里的欧氏距离(L2 范数)不能超过 ϵ \epsilon ϵ
max θ ′ ( θ ′ − θ ) T ∇ θ J ( θ ) s.t. ∥ θ ′ − θ ∥ 2 ≤ ϵ \max_{\theta'} (\theta' - \theta)^T \nabla_\theta J(\theta) \quad \text{s.t.} \quad \|\theta' - \theta\|^2 \le \epsilon θ ′ max ( θ ′ − θ ) T ∇ θ J ( θ ) s.t. ∥ θ ′ − θ ∥ 2 ≤ ϵ 可能存在有些参数稍微变一点,输出概率就会巨变;而有些参数变很多,概率却几乎不变的情况。因为参数空间的几何结构,无法反映机器人行为的真实变化。
为了衡量两个行为空间概率分布之间的距离,我们引入了与参数无关的度量——KL 散度(KL-Divergence)
max θ ′ ( θ ′ − θ ) T ∇ θ J ( θ ) s.t. D KL ( π θ ′ ∥ π θ ) ≤ ϵ \max_{\theta'} (\theta' - \theta)^T \nabla_\theta J(\theta) \quad \text{s.t.} \quad D_{\text{KL}}(\pi_{\theta'} \parallel \pi_\theta) \le \epsilon θ ′ max ( θ ′ − θ ) T ∇ θ J ( θ ) s.t. D KL ( π θ ′ ∥ π θ ) ≤ ϵ
无论你的神经网络怎么设计、参数怎么变,它逼迫新旧策略输出的实际动作概率分布的差距 永远被锁死在 ϵ \epsilon ϵ
虽然上面的 KL 散度约束在物理上很完美,但在数学上,KL 散度是一个高度非线性的复杂函数,直接求解这个受限优化问题极其困难。为了在计算机里高效求解,数学家们对 D KL ( π θ ′ ∥ π θ ) D_{\text{KL}}(\pi_{\theta'} \parallel \pi_\theta) D KL ( π θ ′ ∥ π θ ) θ \theta θ 二阶泰勒展开 ,零阶项,一阶项在 θ \theta θ 0 0 0 费舍尔信息矩阵 。因此,当更新步长很小时,KL 散度可以近似写为一个关于参数偏差的二次型:D KL ( π θ ′ ∥ π θ ) ≈ 1 2 ( θ ′ − θ ) T F ( θ ′ − θ ) D_{\text{KL}}(\pi_{\theta'} \parallel \pi_\theta) \approx \frac{1}{2} (\theta' - \theta)^T \mathbf{F} (\theta' - \theta) D KL ( π θ ′ ∥ π θ ) ≈ 2 1 ( θ ′ − θ ) T F ( θ ′ − θ ) F \mathbf{F} F F = E π θ [ ∇ θ log π θ ( a ∣ s ) ∇ θ log π θ ( a ∣ s ) T ] \mathbf{F} = \mathbb{E}_{\pi_\theta} \left[ \nabla_\theta \log \pi_\theta(\mathbf{a}|\mathbf{s}) \nabla_\theta \log \pi_\theta(\mathbf{a}|\mathbf{s})^T \right] F = E π θ [ ∇ θ log π θ ( a ∣ s ) ∇ θ log π θ ( a ∣ s ) T ]
F \mathbf{F} F
利用拉格朗日乘子法求解这个以 F \mathbf{F} F
θ ← θ + α F − 1 ∇ θ J ( θ ) \theta \leftarrow \theta + \alpha \mathbf{F}^{-1} \nabla_\theta J(\theta) θ ← θ + α F − 1 ∇ θ J ( θ ) 在策略梯度前面乘了一个 F − 1 \mathbf{F}^{-1} F − 1
如果某个参数方向对概率分布的改变极度敏感(F \mathbf{F} F F − 1 \mathbf{F}^{-1} F − 1
如果某个方向对概率改变极度迟钝(F \mathbf{F} F F − 1 \mathbf{F}^{-1} F − 1
这确保了无论参数空间如何扭曲,机器人在实际行为空间里,每一步都迈着大小合适的步子更新策略。更现代的方法信赖域策略优化 TRPO,使用共轭梯度同时计算 α \alpha α
Importance Sampling
策略梯度是一个 on-policy 算法,但我们可以引出一个 off-policy 的变体。重要性采样是一个 Off-policy 中的经典设计,假设我们想计算 r ( x ) r(x) r ( x ) p ( x ) p(x) p ( x ) E x ∼ p [ r ( x ) ] \mathbb{E}_{x \sim p}[r(x)] E x ∼ p [ r ( x )] p ( x ) p(x) p ( x ) q ( x ) q(x) q ( x ) π ˉ \bar{\pi} π ˉ
E x ∼ p [ r ( x ) ] = ∫ p ( x ) r ( x ) d x = ∫ q ( x ) q ( x ) p ( x ) r ( x ) d x = ∫ q ( x ) [ p ( x ) q ( x ) ] ⏟ 重要性权重 w ( x ) r ( x ) d x \mathbb{E}_{x \sim p}[r(x)] = \int p(x)r(x)dx = \int \frac{q(x)}{q(x)} p(x)r(x)dx = \int q(x) \underbrace{\left[ \frac{p(x)}{q(x)} \right]}_{\text{重要性权重 } w(x)} r(x)dx E x ∼ p [ r ( x )] = ∫ p ( x ) r ( x ) d x = ∫ q ( x ) q ( x ) p ( x ) r ( x ) d x = ∫ q ( x ) 重要性权重 w ( x ) [ q ( x ) p ( x ) ] r ( x ) d x 因为积分号外面现在是 q ( x ) d x q(x)dx q ( x ) d x q ( x ) q(x) q ( x ) = E x ∼ q [ p ( x ) q ( x ) r ( x ) ] = \mathbb{E}_{x \sim q} \left[ \frac{p(x)}{q(x)} r(x) \right] = E x ∼ q [ q ( x ) p ( x ) r ( x ) ]
这里的比值 w ( x ) = p ( x ) q ( x ) w(x) = \frac{p(x)}{q(x)} w ( x ) = q ( x ) p ( x )
展开轨迹概率公式 p θ ( τ ) p ˉ ( τ ) = ∏ t = 1 T π θ ( a t ∣ s t ) ∏ t = 1 T π ˉ ( a t ∣ s t ) \frac{p_\theta(\tau)}{\bar{p}(\tau)} = \frac{\prod_{t=1}^T \pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}{\prod_{t=1}^T \bar{\pi}(\mathbf{a}_t | \mathbf{s}_t)} p ˉ ( τ ) p θ ( τ ) = ∏ t = 1 T π ˉ ( a t ∣ s t ) ∏ t = 1 T π θ ( a t ∣ s t ) p ( s 1 ) p(\mathbf{s}_1) p ( s 1 ) p ( s t + 1 ∣ s t , a t ) p(\mathbf{s}_{t+1} | \mathbf{s}_t, \mathbf{a}_t) p ( s t + 1 ∣ s t , a t )
First-Order Approximation
但是重要性采样的权重在整条轨迹上进行计算:
∇ θ ′ J ( θ ′ ) = E τ ∼ p θ ( τ ) [ ( ∏ t ′ = 1 T π θ ′ ( a t ′ ∣ s t ′ ) π θ ( a t ′ ∣ s t ′ ) ) ( ∑ t = 1 T ∇ θ ′ log π θ ′ ( a t ∣ s t ) ) ( ∑ t = 1 T r ( s t , a t ) ) ] \nabla_{\theta'} J(\theta') = \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \left( \prod_{t'=1}^T \frac{\pi_{\theta'}(\mathbf{a}_{t'}|\mathbf{s}_{t'})}{\pi_\theta(\mathbf{a}_{t'}|\mathbf{s}_{t'})} \right) \left( \sum_{t=1}^T \nabla_{\theta'} \log \pi_{\theta'}(\mathbf{a}_t|\mathbf{s}_t) \right) \left( \sum_{t=1}^T r(\mathbf{s}_t, \mathbf{a}_t) \right) \right] ∇ θ ′ J ( θ ′ ) = E τ ∼ p θ ( τ ) [ ( t ′ = 1 ∏ T π θ ( a t ′ ∣ s t ′ ) π θ ′ ( a t ′ ∣ s t ′ ) ) ( t = 1 ∑ T ∇ θ ′ log π θ ′ ( a t ∣ s t ) ) ( t = 1 ∑ T r ( s t , a t ) ) ]
由于 T T T 1 1 1 ∏ t ′ = 1 T \prod_{t'=1}^T ∏ t ′ = 1 T
为了解决指数连乘,我们将整体轨迹期望拆解为每个独立时间步 t t t :
J ( θ ) = ∑ t = 1 T E s t , a t ∼ p θ [ r ( s t , a t ) ] J(\theta) = \sum_{t=1}^T \mathbb{E}_{\mathbf{s}_t, \mathbf{a}_t \sim p_\theta} [r(\mathbf{s}_t, \mathbf{a}_t)] J ( θ ) = t = 1 ∑ T E s t , a t ∼ p θ [ r ( s t , a t )] 对这一项进行单步重要性采样,得到了两个比例的乘积:
p θ ′ ( s t , a t ) p θ ( s t , a t ) = p θ ′ ( s t ) p θ ( s t ) ⏟ 状态边际比例 ⋅ π θ ′ ( a t ∣ s t ) π θ ( a t ∣ s t ) ⏟ 单步动作比例 \frac{p_{\theta'}(\mathbf{s}_t, \mathbf{a}_t)}{p_\theta(\mathbf{s}_t, \mathbf{a}_t)} = \underbrace{\frac{p_{\theta'}(\mathbf{s}_t)}{p_\theta(\mathbf{s}_t)}}_{\text{状态边际比例}} \cdot \underbrace{\frac{\pi_{\theta'}(\mathbf{a}_t | \mathbf{s}_t)}{\pi_\theta(\mathbf{a}_t | \mathbf{s}_t)}}_{\text{单步动作比例}} p θ ( s t , a t ) p θ ′ ( s t , a t ) = 状态边际比例 p θ ( s t ) p θ ′ ( s t ) ⋅ 单步动作比例 π θ ( a t ∣ s t ) π θ ′ ( a t ∣ s t ) 接着做出一阶近似,忽略状态边际概率之比,将其当作 1 1 1 θ ′ ≈ θ \theta' \approx \theta θ ′ ≈ θ p θ ′ ( s t ) ≈ p θ ( s t ) p_{\theta'}(\mathbf{s}_t) \approx p_\theta(\mathbf{s}_t) p θ ′ ( s t ) ≈ p θ ( s t ) D KL ( π θ ∥ π θ ′ ) ≤ δ D_{\text{KL}}(\pi_\theta \parallel \pi_{\theta'}) \le \delta D KL ( π θ ∥ π θ ′ ) ≤ δ
由于忽略状态边际概率的前置条件是新旧策略不能相差太大,现代强化学习算法开始围绕如何把策略限制在安全区(Trust Region)内进行架构设计:
PPO:在训练更新时,PPO 引入了 Clipping(截断) 机制,将新旧动作更新比例 r t ( θ ) r_t(\theta) r t ( θ ) [ 1 − ϵ , 1 + ϵ ] [1-\epsilon, 1+\epsilon] [ 1 − ϵ , 1 + ϵ ] ϵ = 0.2 \epsilon = 0.2 ϵ = 0.2
GRPO:继承了 PPO 逐步优化和一阶近似的思想,同时去掉 critic 网络,对于同一个问题(Prompt),GRPO 采样一组(如 G = 64 G=64 G = 64 mean \text{mean} mean std \text{std} std i i i A i = r i − mean ( r ) std ( r ) A_i = \frac{r_i - \text{mean}(r)}{\text{std}(r)} A i = std ( r ) r i − mean ( r )
Actor-Critic
improve PG
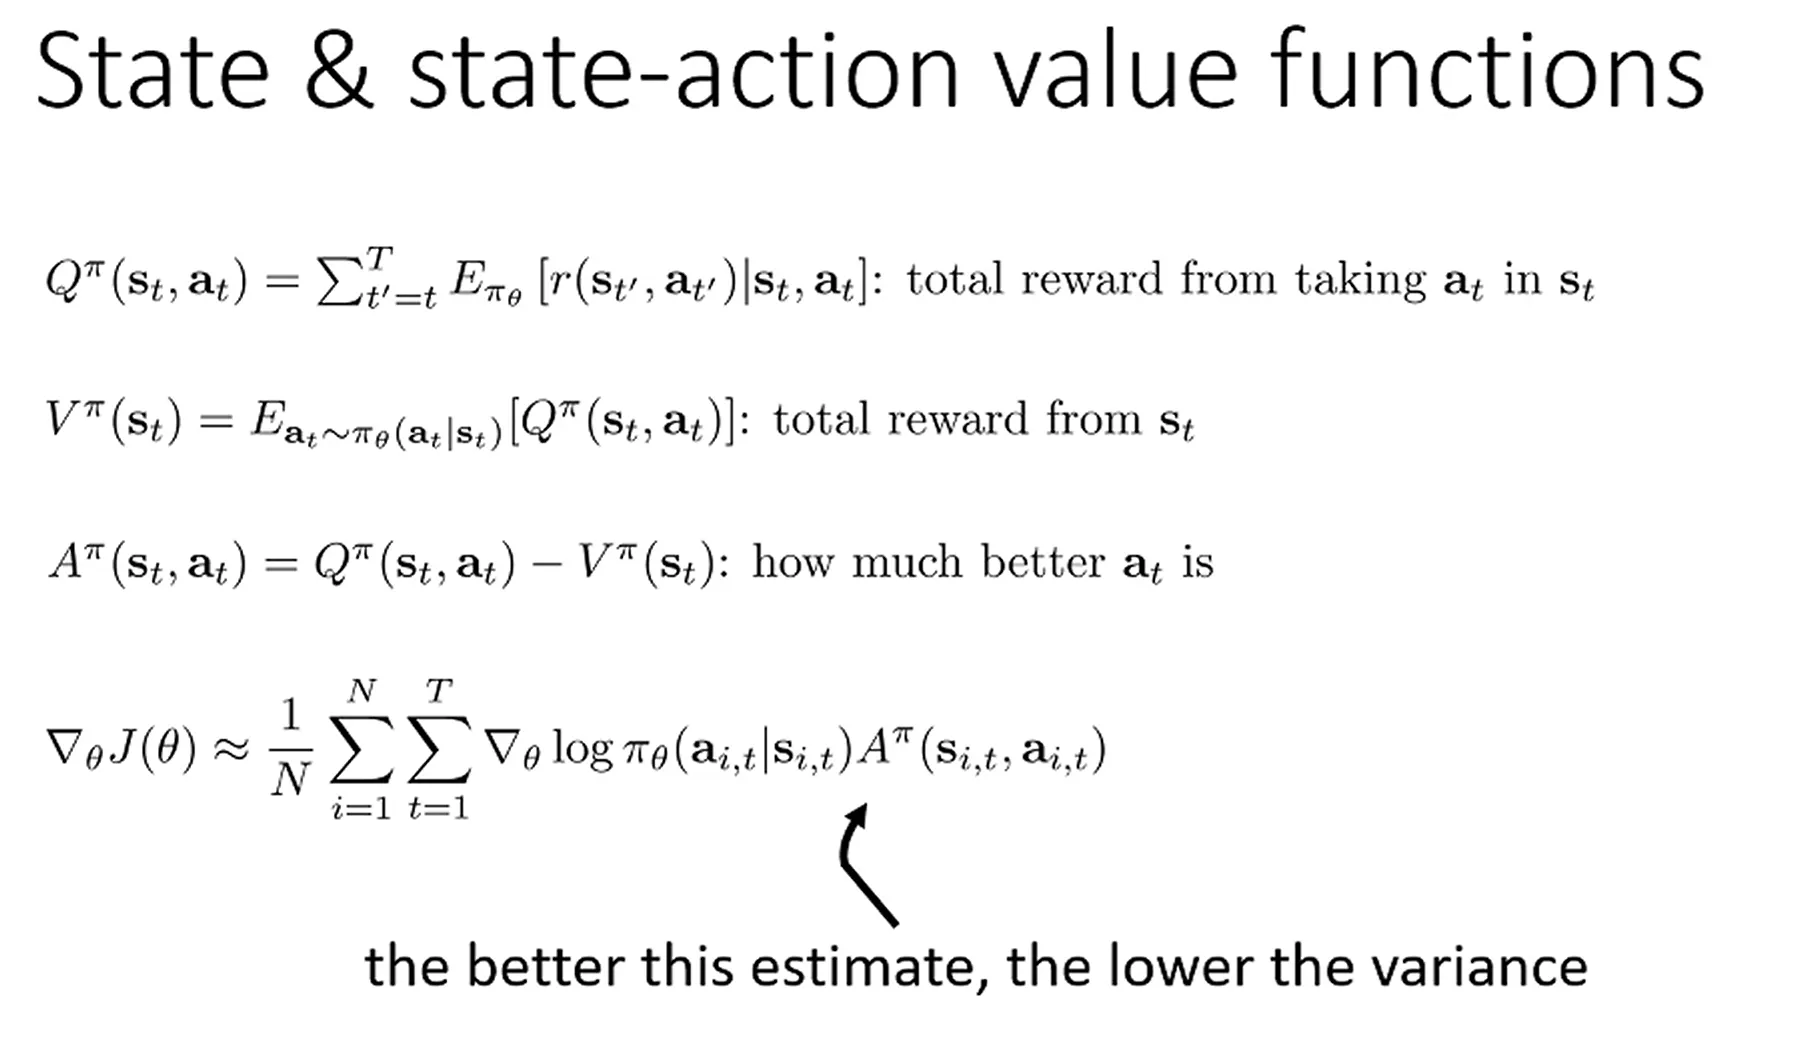
V ( s t ) V(s_t) V ( s t ) a t a_t a t s t s_t s t
但在实际计算中,我们无法知道精确的 Q ( s , a ) Q(s,a) Q ( s , a ) V ( s ) V(s) V ( s ) V ( s ) V(s) V ( s )
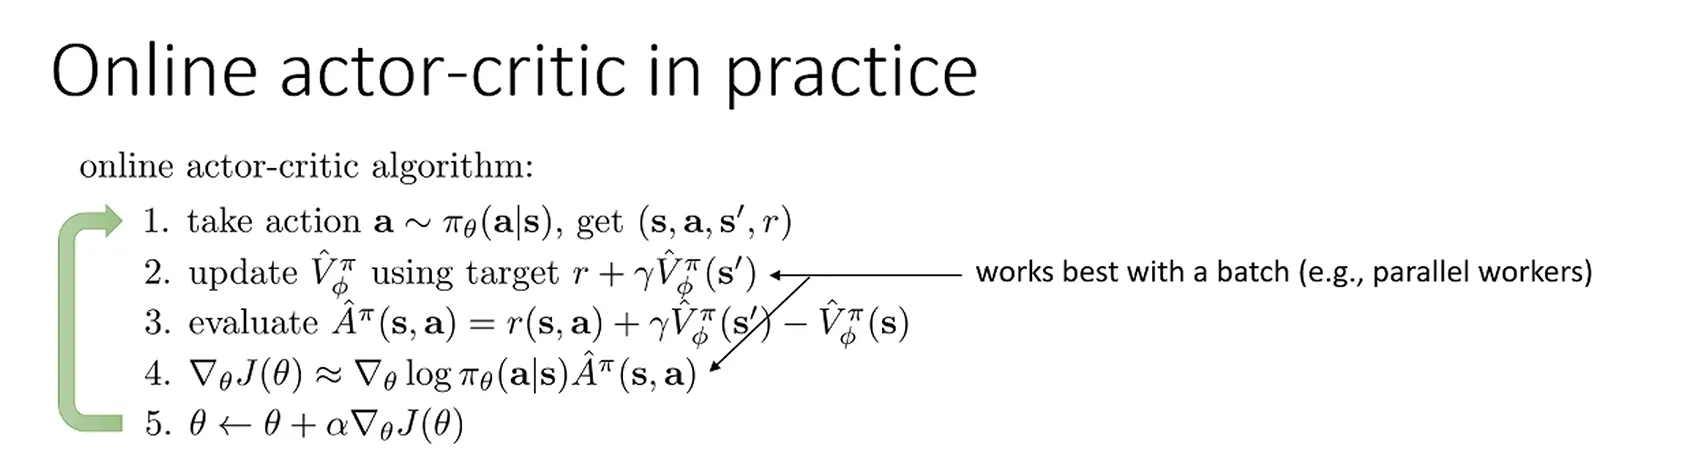
通常使用蒙特卡洛采样得到数据来approximate value function,虽然蒙特卡洛能提供真实的、无偏的未来回报标签,但由于其累积方差过大,在工程上我们通常更进一步采用自举的方式。通过用当前网络对下一步的价值估计 V ( s t + 1 ) V(s_{t+1}) V ( s t + 1 ) Q π ( s t , a t ) = E [ r ( s t , a t ) + γ V π ( s t + 1 ) ] Q^\pi(s_t, a_t) = \mathbb{E}[r(s_t, a_t) + \gamma V^\pi(s_{t+1})] Q π ( s t , a t ) = E [ r ( s t , a t ) + γ V π ( s t + 1 )] γ \gamma γ
A π ( s t , a t ) = Q π ( s t , a t ) − V π ( s t ) ≈ r ( s t , a t ) + γ V π ( s t + 1 ) − V π ( s t ) ⏟ TD Error(时序差分误差) A^\pi(s_t, a_t) = Q^\pi(s_t, a_t) - V^\pi(s_t) \approx \underbrace{r(s_t, a_t) + \gamma V^\pi(s_{t+1}) - V^\pi(s_t)}_{\text{TD Error(时序差分误差)}} A π ( s t , a t ) = Q π ( s t , a t ) − V π ( s t ) ≈ TD Error (时序差分误差) r ( s t , a t ) + γ V π ( s t + 1 ) − V π ( s t )
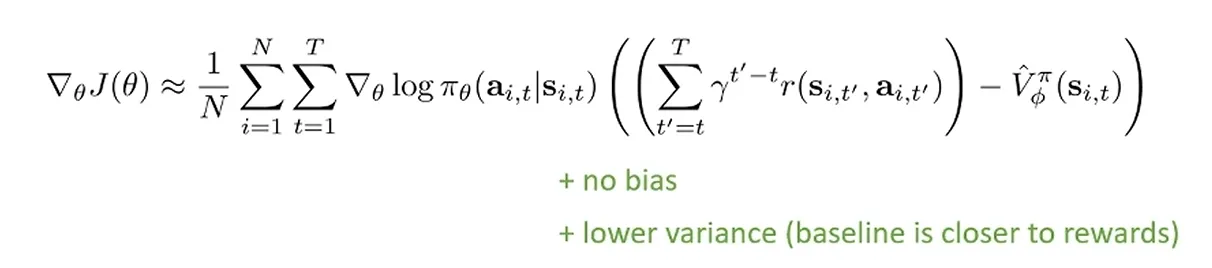
actor-critic 算法优点是更低的方差,缺点是不再无偏,因为critic是基于有限样本训练的函数逼近器。用下图的蒙特卡洛优势估计器就可以既无偏又有较低方差,但存在的问题是无法像actor-critic一样逐步优化了。
如果使用基于状态和动作的baseline方差还能更低,但也会更加复杂,因为基于动作的baseline就不能保证无偏了,需要另外加上校正项。它相当于一种 control variate(控制变量)用高方差随机量 - 相关的近似量 + 近似量的精确期望。计算策略梯度时,Q ϕ Q_\phi Q ϕ θ \theta θ detach 或stop_gradient。如果 Q ϕ Q_\phi Q ϕ
∇ θ E π [ Q ϕ ] = E π [ ∇ θ log π Q ϕ ] + E π [ ∇ θ Q ϕ ] , \nabla_\theta\mathbb E_\pi[Q_\phi]
=
\mathbb E_\pi[
\nabla_\theta\log\pi\,Q_\phi
]
+
\mathbb E_\pi[
\nabla_\theta Q_\phi
], ∇ θ E π [ Q ϕ ] = E π [ ∇ θ log π Q ϕ ] + E π [ ∇ θ Q ϕ ] , 会额外出现E π [ ∇ θ Q ϕ ] \mathbb E_\pi[\nabla_\theta Q_\phi] E π [ ∇ θ Q ϕ ]
GAE
将actor-critic和蒙特卡洛优势估计结合,我们就能得到 n 步优势估计器。随着 n n n
A ^ n π ( s t , a t ) = ∑ l = 0 n − 1 γ l r t + l + γ n V ^ ( s t + n ) − V ^ ( s t ) \hat{A}_n^\pi(s_t, a_t) = \sum_{l=0}^{n-1} \gamma^l r_{t+l} + \gamma^n \hat{V}(s_{t+n}) - \hat{V}(s_t) A ^ n π ( s t , a t ) = l = 0 ∑ n − 1 γ l r t + l + γ n V ^ ( s t + n ) − V ^ ( s t ) 在实际训练中,选择某一个固定的 n n n n = 1 n=1 n = 1 n = ∞ n=\infty n = ∞ A ^ n π \hat{A}_n^\pi A ^ n π
A ^ GAE π ( s t , a t ) = ∑ n = 1 ∞ w n A ^ n π ( s t , a t ) \hat{A}_{\text{GAE}}^\pi(s_t, a_t) = \sum_{n=1}^\infty w_n \hat{A}_n^\pi(s_t, a_t) A ^ GAE π ( s t , a t ) = n = 1 ∑ ∞ w n A ^ n π ( s t , a t ) n n n n n n A ^ n π ( s t , a t ) = ∑ l = 0 n − 1 γ l δ t + l \hat{A}_n^\pi(s_t, a_t) = \sum_{l=0}^{n-1} \gamma^l \delta_{t+l} A ^ n π ( s t , a t ) = ∑ l = 0 n − 1 γ l δ t + l
推导(以 n = 2 n=2 n = 2 :
\delta_t + \gamma \delta_{t+1} &= \left( r_t + \gamma \hat{V}(s_{t+1}) - \hat{V}(s_t) \right) + \gamma \left( r_{t+1} + \gamma \hat{V}(s_{t+2}) - \hat{V}(s_{t+1}) \right) \\
&= r_t + \gamma r_{t+1} + \gamma^2 \hat{V}(s_{t+2}) - \hat{V}(s_t) \\
&= \hat{A}_2^\pi(s_t, a_t)
\end{aligned}$$
为了让它成为一个合理的加权平均,权重必须满足:
归一化条件:∑ n = 1 ∞ w n = 1 \sum_{n=1}^\infty w_n = 1 ∑ n = 1 ∞ w n = 1
越早截断方差越小,因此更希望给较小的 n n n
为此,引入指数衰减权重:w n ∝ λ n − 1 w_n \propto \lambda^{n-1} w n ∝ λ n − 1 λ ∈ [ 0 , 1 ] \lambda \in [0, 1] λ ∈ [ 0 , 1 ]
∑ n = 1 ∞ w n = ∑ n = 1 ∞ C λ n − 1 = C 1 1 − λ = 1 ⟹ C = 1 − λ \sum_{n=1}^\infty w_n = \sum_{n=1}^\infty C \lambda^{n-1} = C \frac{1}{1-\lambda} = 1 \implies C = 1-\lambda n = 1 ∑ ∞ w n = n = 1 ∑ ∞ C λ n − 1 = C 1 − λ 1 = 1 ⟹ C = 1 − λ 因此,合理的归一化权重分配为:w n = ( 1 − λ ) λ n − 1 w_n = (1-\lambda)\lambda^{n-1} w n = ( 1 − λ ) λ n − 1 w n = ( 1 − λ ) λ n − 1 w_n = (1-\lambda)\lambda^{n-1} w n = ( 1 − λ ) λ n − 1 n n n A ^ n π ( s t , a t ) = ∑ l = 0 n − 1 γ l δ t + l \hat{A}_n^\pi(s_t, a_t) = \sum_{l=0}^{n-1} \gamma^l \delta_{t+l} A ^ n π ( s t , a t ) = ∑ l = 0 n − 1 γ l δ t + l
A ^ GAE π ( s t , a t ) = ∑ n = 1 ∞ ( 1 − λ ) λ n − 1 ( ∑ l = 0 n − 1 γ l δ t + l ) \hat{A}_{\text{GAE}}^\pi(s_t, a_t) = \sum_{n=1}^\infty (1-\lambda)\lambda^{n-1} \left( \sum_{l=0}^{n-1} \gamma^l \delta_{t+l} \right) A ^ GAE π ( s t , a t ) = n = 1 ∑ ∞ ( 1 − λ ) λ n − 1 ( l = 0 ∑ n − 1 γ l δ t + l ) 这里使用一个交换双重求和的顺序的代数技巧将不依赖于 n n n
A ^ GAE π ( s t , a t ) = ∑ l = 0 ∞ γ l δ t + l ( 1 − λ ) ( ∑ n = l + 1 ∞ λ n − 1 ) \hat{A}_{\text{GAE}}^\pi(s_t, a_t) = \sum_{l=0}^\infty \gamma^l \delta_{t+l} (1-\lambda) \left( \sum_{n=l+1}^\infty \lambda^{n-1} \right) A ^ GAE π ( s t , a t ) = l = 0 ∑ ∞ γ l δ t + l ( 1 − λ ) ( n = l + 1 ∑ ∞ λ n − 1 ) 计算内层关于 n n n k = n − ( l + 1 ) k = n - (l+1) k = n − ( l + 1 )
∑ n = l + 1 ∞ λ n − 1 = λ l ∑ k = 0 ∞ λ k = λ l 1 1 − λ \sum_{n=l+1}^\infty \lambda^{n-1} = \lambda^l \sum_{k=0}^\infty \lambda^k = \lambda^l \frac{1}{1-\lambda} n = l + 1 ∑ ∞ λ n − 1 = λ l k = 0 ∑ ∞ λ k = λ l 1 − λ 1 将计算结果代回:
A ^ GAE π ( s t , a t ) = ∑ l = 0 ∞ γ l δ t + l ( 1 − λ ) ( λ l 1 1 − λ ) = ∑ l = 0 ∞ ( γ λ ) l δ t + l \hat{A}_{\text{GAE}}^\pi(s_t, a_t) = \sum_{l=0}^\infty \gamma^l \delta_{t+l} (1-\lambda) \left( \lambda^l \frac{1}{1-\lambda} \right) = \sum_{l=0}^\infty (\gamma\lambda)^l \delta_{t+l} A ^ GAE π ( s t , a t ) = l = 0 ∑ ∞ γ l δ t + l ( 1 − λ ) ( λ l 1 − λ 1 ) = l = 0 ∑ ∞ ( γ λ ) l δ t + l 如果令时间步 t ′ = t + l t' = t+l t ′ = t + l GAE 公式 :
A ^ GAE π ( s t , a t ) = ∑ t ′ = t ∞ ( γ λ ) t ′ − t δ t ′ \hat{A}_{\text{GAE}}^\pi(s_t, a_t) = \sum_{t'=t}^\infty (\gamma\lambda)^{t'-t} \delta_{t'} A ^ GAE π ( s t , a t ) = t ′ = t ∑ ∞ ( γ λ ) t ′ − t δ t ′ 引入 λ \lambda λ ( γ λ ) (\gamma\lambda) ( γ λ ) λ = 0 \lambda = 0 λ = 0 λ = 1 \lambda = 1 λ = 1 λ ∈ ( 0 , 1 ) \lambda \in (0, 1) λ ∈ ( 0 , 1 ) λ = 0.95 \lambda = 0.95 λ = 0.95
将 GAE 通用公式 ∑ t ′ = t ∞ ( γ λ ) t ′ − t δ t ′ \sum_{t'=t}^\infty (\gamma\lambda)^{t'-t} \delta_{t'} ∑ t ′ = t ∞ ( γ λ ) t ′ − t δ t ′ δ t ′ \delta_{t'} δ t ′ r t ′ + γ V ^ t ′ + 1 − V ^ t ′ r_{t'} + \gamma \hat{V}_{t'+1} - \hat{V}_{t'} r t ′ + γ V ^ t ′ + 1 − V ^ t ′ A ^ GAE , t π = − V ^ ( s t ) + r t + γ ( 1 − λ ) V ^ ( s t + 1 ) + γ λ r t + 1 + γ 2 λ ( 1 − λ ) V ^ ( s t + 2 ) + … \hat{A}_{\text{GAE}, t}^\pi = - \hat{V}(s_t) + r_t + \gamma(1-\lambda)\hat{V}(s_{t+1}) + \gamma\lambda r_{t+1} + \gamma^2\lambda(1-\lambda)\hat{V}(s_{t+2}) + \dots A ^ GAE , t π = − V ^ ( s t ) + r t + γ ( 1 − λ ) V ^ ( s t + 1 ) + γ λ r t + 1 + γ 2 λ ( 1 − λ ) V ^ ( s t + 2 ) + …
value-based
舍弃显式的策略网络,直接使用 value 来做出决策选择行动,此时我们需要学习的只有 value function(Q 或 V),该函数可以用表格 或神经网络 表示。
Policy Iteration
学习的是状态价值 V π ( s ) V^\pi(s) V π ( s ) π \pi π V π ( s ) V^\pi(s) V π ( s ) V π ( s ) V^\pi(s) V π ( s ) π ′ \pi' π ′ P ( s ′ ∣ s , a ) P(s'|s,a) P ( s ′ ∣ s , a )
π ′ ( s ) ← arg max a ( r ( s , a ) + γ ∑ s ′ P ( s ′ ∣ s , a ) V π ( s ′ ) ) \pi'(s) \leftarrow \arg\max_a \left( r(s,a) + \gamma \sum_{s'} P(s'|s,a) V^\pi(s') \right) π ′ ( s ) ← arg a max ( r ( s , a ) + γ s ′ ∑ P ( s ′ ∣ s , a ) V π ( s ′ ) ) 也可以将推广到学习动作价值 Q π ( s , a ) Q^\pi(s,a) Q π ( s , a ) π ′ ( s ) ← arg max a Q π ( s , a ) \pi'(s) \leftarrow \arg\max_a Q^\pi(s,a) π ′ ( s ) ← arg max a Q π ( s , a ) π \pi π Q π ( s , a ) Q^\pi(s,a) Q π ( s , a ) Q π ( s , a ) Q^\pi(s,a) Q π ( s , a ) π ′ \pi' π ′
Fitted Value Iteration
算法的目标是找最优价值函数 V ∗ ( s ) V^*(s) V ∗ ( s ) y i ← max a i ( r ( s i , a i ) + γ E [ V ϕ ( s i ′ ) ] ) y_i \leftarrow \max_{\mathbf{a}_i} \left( r(\mathbf{s}_i, \mathbf{a}_i) + \gamma \mathbb{E}[V_\phi(\mathbf{s}'_i)] \right) y i ← max a i ( r ( s i , a i ) + γ E [ V ϕ ( s i ′ )] )
为了找出能让右边达到最大的动作 a i \mathbf{a}_i a i s i \mathbf{s}_i s i s i ′ \mathbf{s}'_i s i ′
Fitted Q-Iteration
将拟合目标从 V ( s ) V(\mathbf{s}) V ( s ) Q ( s , a ) Q(\mathbf{s}, \mathbf{a}) Q ( s , a ) y i ← r ( s i , a i ) + γ max a i ′ Q ϕ ( s i ′ , a i ′ ) y_i \leftarrow r(\mathbf{s}_i, \mathbf{a}_i) + \gamma \max_{\mathbf{a}'_i} Q_\phi(\mathbf{s}'_i, \mathbf{a}'_i) y i ← r ( s i , a i ) + γ max a i ′ Q ϕ ( s i ′ , a i ′ )
这个过程完全在神经网络内部完成,不需要任何物理环境的模拟或预测。我们不需要知道转移概率,只要有采样获得的样本就能拟合函数。
但是非线性函数逼近不能保证收敛,由于 ℓ ∞ \ell_\infty ℓ ∞ ℓ 2 \ell_2 ℓ 2 DQN 在 FQI 的基础上引入了 Target Network 和 Replay Buffer 来缓解非线性函数逼近器的不稳定性。
如果只是 argmax的策略初始可能每次都采取相同的动作而不去发现更好的动作,于是采用 epsilon-greedy 的方法,以 ϵ \epsilon ϵ 1 − ϵ 1-\epsilon 1 − ϵ ϵ \epsilon ϵ Boltzmann Exploration ,将每个动作的 Q 值转换为采取该动作的概率,概率与 Q 值的指数成正比,给那些次优动作更多的探索机会,而几乎不给那些差的动作机会,后面还会专门讨论更复杂的探索方法。
DQN
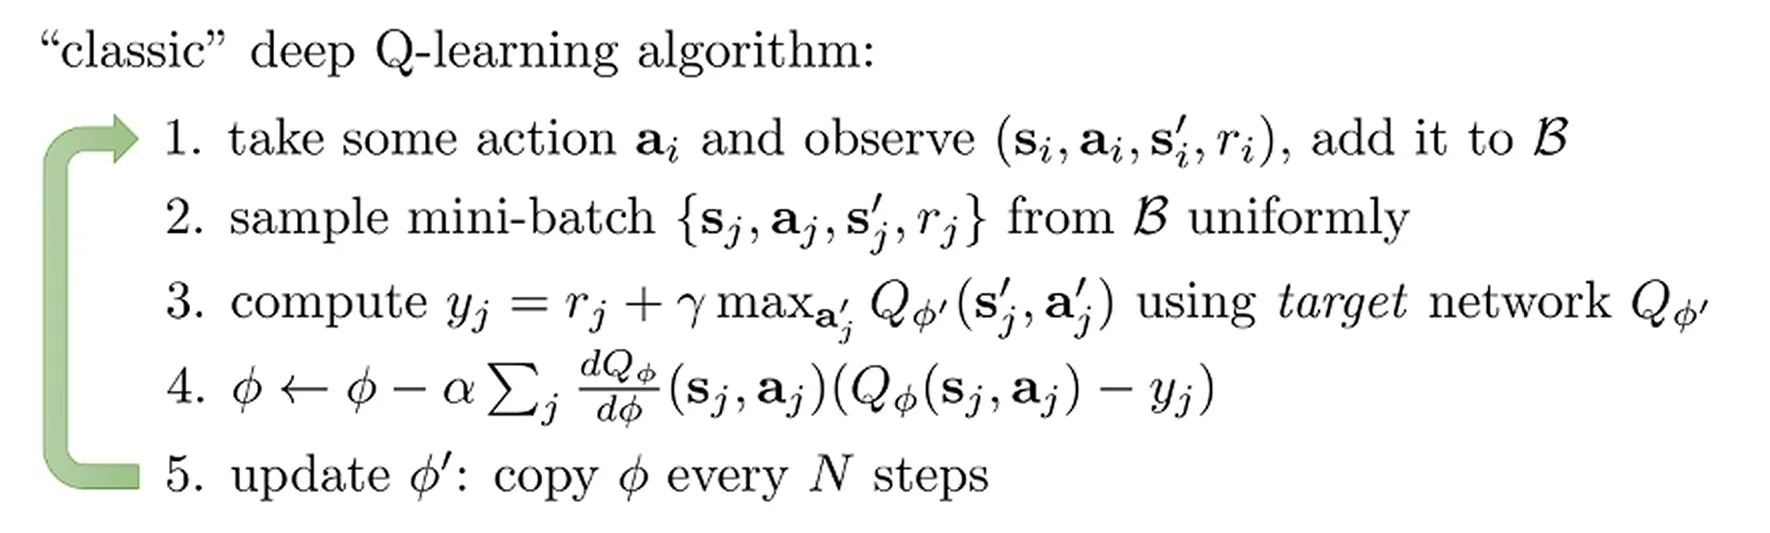
在环境里每走一步 就收集一个样本加到 B \mathcal{B} B B \mathcal{B} B ϕ \phi ϕ 一次 梯度更新,每隔 N N N ϕ \phi ϕ ϕ ′ \phi' ϕ ′
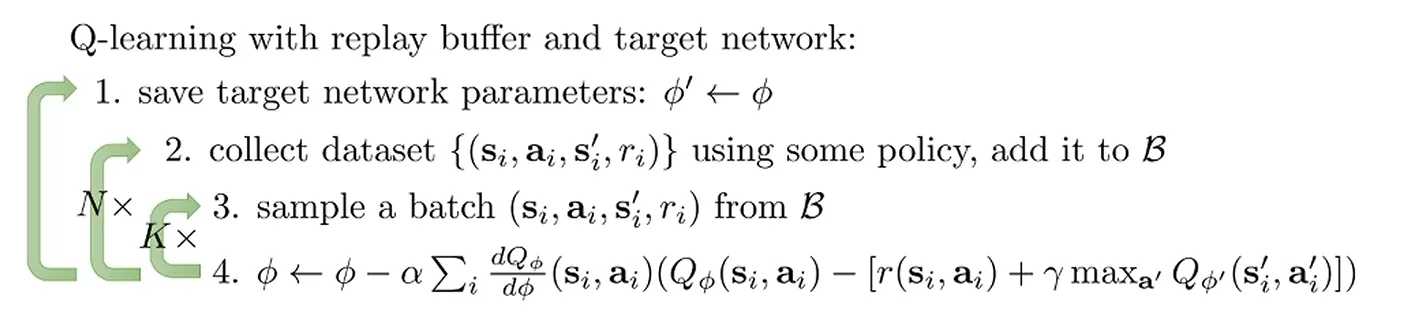
先让智能体在环境里连续跑很多步,收集一大批数据存入 B \mathcal{B} B B \mathcal{B} B ϕ \phi ϕ K K K
Replay Buffer(经验回放区)稳定了 ℓ 2 \ell_2 ℓ 2 Π \Pi Π ( s t , a t , r t , s t + 1 ) (s_t, a_t, r_t, s_{t+1}) ( s t , a t , r t , s t + 1 ) 极强的时序相关性 。这违背了机器学习中“样本独立同分布”的假设,导致神经网络产生严重过拟合或灾难性遗忘,使得投影算子 Π \Pi Π B \mathcal{B} B 随机均匀采样 ,削弱短程时间相关性,并平滑不断变化的数据分布
Target Network(目标网络)稳定了 ℓ ∞ \ell_\infty ℓ ∞ B \mathcal{B} B ϕ \phi ϕ 自举 过程会在范数冲突中产生致命的正反馈调节。网络微小的拟合偏差会立刻反映在目标值上,并在下一次更新中被放大,最终导致发散。引入一个参数暂时冻结的目标网络 ϕ ′ \phi' ϕ ′ ϕ ′ \phi' ϕ ′
Double Q-learning
数学上存在一个不等式:E [ max ( X 1 , X 2 ) ] ≥ max ( E [ X 1 ] , E [ X 2 ] ) \mathbb{E}[\max(X_1, X_2)] \ge \max(\mathbb{E}[X_1], \mathbb{E}[X_2]) E [ max ( X 1 , X 2 )] ≥ max ( E [ X 1 ] , E [ X 2 ])
而在标准 DQN 中 Q function 在逼近 Q Q Q y = r + γ max a ′ Q ϕ ′ ( s ′ , a ′ ) = r + γ max a ′ Q ϕ ′ ( s ′ , arg max a ′ Q ϕ ′ ( s ′ , a ′ ) ) y = r + \gamma \max_{a'} Q_{\phi'}(s', a') = r + \gamma \max_{a'} Q_{\phi'}\Big( s', \arg\max_{a'} Q_{\phi'}(s', a')\Big) y = r + γ max a ′ Q ϕ ′ ( s ′ , a ′ ) = r + γ max a ′ Q ϕ ′ ( s ′ , arg max a ′ Q ϕ ′ ( s ′ , a ′ ) )
也就构成了与上方不等式类似形式。由于自举机制,这个高估的误差会随着时序反向传播,导致所有状态的 Q Q Q arg max \arg\max arg max Q ϕ ′ Q_{\phi'} Q ϕ ′ ϕ ′ \phi' ϕ ′
所以我们可以用两个噪声独立 的网络(两个 Q function)来相互制约,一个负责选动作 a ∗ = arg max a ′ Q A ( s ′ , a ′ ) a^* = \arg\max_{a'} Q_A(s', a') a ∗ = arg max a ′ Q A ( s ′ , a ′ ) Value = Q B ( s ′ , a ∗ ) \text{Value} = Q_B(s', a^*) Value = Q B ( s ′ , a ∗ )
in practice
在实践中会使用实时更新的 Current Network (Q ϕ Q_\phi Q ϕ 和 延迟复制的 **Target Network (Q ϕ ′ Q_{\phi'} Q ϕ ′ y = r + γ Q ϕ ′ ( s ′ , arg max a ′ Q ϕ ( s ′ , a ′ ) ) y = r + \gamma Q_{\phi'}\Big(s', \arg\max_{a'} \mathbf{Q_\phi}(s', a')\Big) y = r + γ Q ϕ ′ ( s ′ , arg max a ′ Q ϕ ( s ′ , a ′ ) )
多步 Q-learning
目标值需要累加后续多步的真实历史奖励:
y t = r t + γ r t + 1 + γ 2 r t + 2 + ⋯ + γ N max a ′ Q ( s t + N , a ′ ) y_{t} = r_t + \gamma r_{t+1} + \gamma^2 r_{t+2} + \dots + \gamma^N \max_{a'} Q(s_{t+N}, a') y t = r t + γ r t + 1 + γ 2 r t + 2 + ⋯ + γ N max a ′ Q ( s t + N , a ′ )
如果learning off-policy,那么后续几步的真实奖励(如 r t + 1 , r t + 2 r_{t+1}, r_{t+2} r t + 1 , r t + 2
为了修正这个偏差,有三种解决方案:
直接把数据集里的 N N N N N N μ \mu μ π \pi π ϵ \epsilon ϵ
一旦在历史轨迹中发现某个动作 a t ′ a_{t'} a t ′ N N N Q Q Q
在累加后续每一步奖励时,都乘上新旧策略的概率比值(重要性权重) ρ t ′ = π ( a t ′ ∣ s t ′ ) μ ( a t ′ ∣ s t ′ ) \rho_{t'} = \frac{\pi(a_{t'}|s_{t'})}{\mu(a_{t'}|s_{t'})} ρ t ′ = μ ( a t ′ ∣ s t ′ ) π ( a t ′ ∣ s t ′ )
为了彻底解决“重要性采样方差爆炸”和“截断轨迹太保守”的矛盾,DeepMind 2016 论文提出了 Retrace(λ \lambda λ 算法,将重要性采样的乘积权重限制(截断)在 1 1 1 c s = λ min ( 1 , π ( a s ∣ s s ) μ ( a s ∣ s s ) ) c_s = \lambda \min\left(1, \frac{\pi(a_s|s_s)}{\mu(a_s|s_s)}\right) c s = λ min ( 1 , μ ( a s ∣ s s ) π ( a s ∣ s s ) )
Q-learning in continuous space
在经典的 Q-learning(如 DQN)中,计算目标值时需要求解一个核心项:y = r + γ max a ′ Q ( s ′ , a ′ ) y = r + \gamma \max_{a'} Q(s', a') y = r + γ max a ′ Q ( s ′ , a ′ )
在每一次迭代中对一个任意复杂的神经网络 Q ( s , a ) Q(s, a) Q ( s , a ) max a Q ( s , a ) \max_a Q(s, a) max a Q ( s , a ) 极其困难且计算昂贵的非线性连续优化问题 。
随机优化法
不追求求出绝对精确的数学最大值,而是通过随机采样 和演化算法 来近似求解 max a Q ( s , a ) \max_a Q(s, a) max a Q ( s , a )
随机采样:直接在连续动作空间中,随机均匀采样 N N N { a 1 , a 2 , … , a N } \{a_1, a_2, \dots, a_N\} { a 1 , a 2 , … , a N } Q Q Q max a Q ( s , a ) ≈ max { Q ( s , a 1 ) , … , Q ( s , a N ) } \max_{\mathbf{a}} Q(\mathbf{s}, \mathbf{a}) \approx \max \{ Q(\mathbf{s}, \mathbf{a}_1), \dots, Q(\mathbf{s}, \mathbf{a}_N) \} max a Q ( s , a ) ≈ max { Q ( s , a 1 ) , … , Q ( s , a N )}
交叉熵方法 (Cross-Entropy Method, CEM) :
首先在动作空间中,根据一个高斯分布随机采样 N N N
计算这 N N N Q Q Q M M M
利用这 M M M
从新的高斯分布中再次采样,重复上述步骤。经过几次迭代,采样分布会迅速收敛到最优动作附近。
在动作空间维度较低时(通常在 40 维 以内)效果很好,如果动作维度过高,采样效率会急剧下降。
设计易于优化的 Q 函数结构
抛弃通用的全连接神经网络,人为限制 Q Q Q Q Q Q a a a 二次型(Quadratic)函数 :Q ϕ ( s , a ) = − 1 2 ( a − μ ϕ ( s ) ) T P ϕ ( s ) ( a − μ ϕ ( s ) ) + V ϕ ( s ) Q_\phi(\mathbf{s}, \mathbf{a}) = -\frac{1}{2}(\mathbf{a} - \mu_\phi(\mathbf{s}))^T P_\phi(\mathbf{s})(\mathbf{a} - \mu_\phi(\mathbf{s})) + V_\phi(\mathbf{s}) Q ϕ ( s , a ) = − 2 1 ( a − μ ϕ ( s ) ) T P ϕ ( s ) ( a − μ ϕ ( s )) + V ϕ ( s )
因为 P ϕ ( s ) P_\phi(\mathbf{s}) P ϕ ( s ) − 1 2 ( a − μ ) T P ( a − μ ) -\frac{1}{2}(\mathbf{a} - \mu)^T P (\mathbf{a} - \mu) − 2 1 ( a − μ ) T P ( a − μ ) 永远小于或等于 0 。显然,当且仅当 a = μ ϕ ( s ) \mathbf{a} = \mu_\phi(\mathbf{s}) a = μ ϕ ( s ) 0 0 0 Q Q Q
学习一个近似的最大值生成网络
既然直接求 max \max max μ θ ( s ) \mu_\theta(\mathbf{s}) μ θ ( s ) s \mathbf{s} s Q Q Q
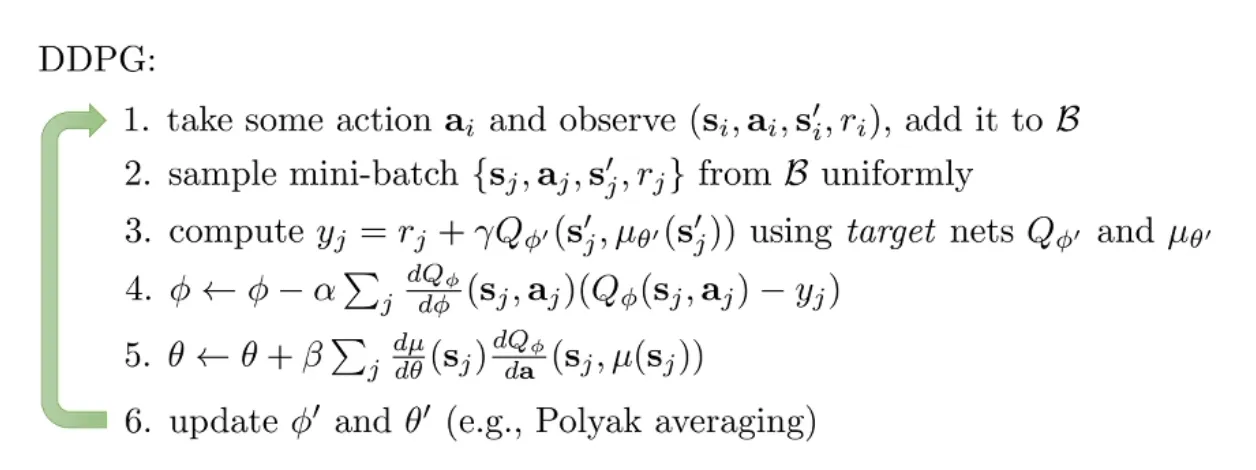
DDPG 本质上就是一种将 Q-learning 推广到连续动作空间 的 Deterministic Actor-Critic 算法。
策略网络 μ θ \mu_\theta μ θ Q Q Q m a x θ E s Q ϕ ( s , μ θ ( s ) ) max_\theta \mathbb{E}_{s} Q_\phi(\mathbf{s}, \mu_\theta(\mathbf{s})) ma x θ E s Q ϕ ( s , μ θ ( s )) Q Q Q a \mathbf{a} a Q Q Q d Q ϕ d θ = d a d θ d Q ϕ d a \frac{dQ_\phi}{d\theta} = \frac{d\mathbf{a}}{d\theta} \frac{dQ_\phi}{d\mathbf{a}} d θ d Q ϕ = d θ d a d a d Q ϕ Q Q Q θ ← θ + β ∑ j d μ d θ ( s j ) d Q ϕ d a ( s j , μ ( s j ) ) \theta \leftarrow \theta + \beta \sum_{j} \frac{d\mu}{d\theta}(\mathbf{s}_j) \frac{dQ_\phi}{d\mathbf{a}}(\mathbf{s}_j, \mu(\mathbf{s}_j)) θ ← θ + β ∑ j d θ d μ ( s j ) d a d Q ϕ ( s j , μ ( s j ))
HW2:Policy Gradients
为什么这里的 Policy Gradient with Baseline 已经有了拟合 Value 的网络,也通过它算出了 Advantage,甚至用了 GAE,却仍归类为PG而不是actor-critic?
Sutton 在其《Reinforcement Learning: An Introduction》一书中是这样界定的:
虽然带 Baseline 的 REINFORCE 方法同时学习了策略和状态价值函数,但我们不认为它是一种 Actor-Critic 方法 。因为它的价值函数只作为 Baseline,而没有用于自举 (依据后续状态的估计值更新当前状态的价值估计),只作为待更新价值估计的状态所对应的基线。
在 pg_agent.py 中,虽然 Actor 使用了 GAE 来计算优势,但是价值网络 V ^ ϕ ( s ) \hat{V}_\phi(s) V ^ ϕ ( s ) y_i = q_values(其中 q_values 是通过将整局轨迹的所有即时奖励一路累加到结尾算出来的),必须收集完一整条完整的轨迹去拟合 Baseline,在本质上依然属于蒙特卡洛策略梯度方法 。
在这里的 Actor-Critic 中, Critic 网络更新的目标值不再是整局的 q_values,而是纯粹的单步自举时序差分目标 y t = r t + γ V ^ ϕ ′ ( s t + 1 ′ ) y_t = r_t + \gamma \hat{V}_{\phi'}(s'_{t+1}) y t = r t + γ V ^ ϕ ′ ( s t + 1 ′ )
HW3:DQN & SAC
我们训练 Actor(策略网络)的最终目标,是让它选出的动作 a a a Q Q Q max θ E a ∼ π θ [ Q ϕ ( s , a ) ] \max_\theta \mathbb{E}_{a \sim \pi_\theta}[Q_\phi(s, a)] max θ E a ∼ π θ [ Q ϕ ( s , a )] 动作 a a a π θ \pi_\theta π θ ,反向传播的梯度一旦碰到“采样”这个节点,就会立刻断掉,无法传回给 Actor 的参数 θ \theta θ
REINFORCE(得分函数估计)
在基础的 Policy Gradient(比如 PPO、A2C)中,为了绕过这个不可导的采样节点可以使用一个对数导数技巧:∇ θ E [ Q ] = E [ Q ( s , a ) ⋅ ∇ θ log π θ ( a ∣ s ) ] \nabla_\theta \mathbb{E}[Q] = \mathbb{E}[Q(s, a) \cdot \nabla_\theta \log \pi_\theta(a|s)] ∇ θ E [ Q ] = E [ Q ( s , a ) ⋅ ∇ θ log π θ ( a ∣ s )]
在这个公式里,Critic 网络 Q ( s , a ) Q(s, a) Q ( s , a ) Q Q Q 方差极大,效率很低 。
重参数化技巧(Reparameterization Trick)
为了能利用 Critic 的梯度,我们使用重参数化技巧把“带参数的采样”解耦成了“确定性公式 + 纯外部噪声”:
a θ = μ θ ( s ) + σ θ ( s ) ⋅ ϵ ( 其中 ϵ ∼ N ( 0 , 1 ) ) a_\theta = \mu_\theta(s) + \sigma_\theta(s) \cdot \epsilon \quad (\text{其中 } \epsilon \sim \mathcal{N}(0, 1)) a θ = μ θ ( s ) + σ θ ( s ) ⋅ ϵ ( 其中 ϵ ∼ N ( 0 , 1 ))
现在,动作 a θ a_\theta a θ 完全确定且处处可导 的数学公式,所有的随机性(不可导性)都被扔给了那个不需要求导的外部常数 ϵ \epsilon ϵ Q Q Q a a a μ θ \mu_\theta μ θ σ θ \sigma_\theta σ θ
既然我们想要最大化 Q Q Q 直接把 Q Q Q 对参数 θ \theta θ ∇ θ Q ϕ ( s , a θ ) = ∂ Q ϕ ∂ a ⏟ Critic 指明的方向 ⋅ ∂ a θ ∂ θ ⏟ Actor 的执行能力 \nabla_\theta Q_\phi(s, a_\theta) = \underbrace{\frac{\partial Q_\phi}{\partial a}}_{\text{Critic 指明的方向}} \cdot \underbrace{\frac{\partial a_\theta}{\partial \theta}}_{\text{Actor 的执行能力}} ∇ θ Q ϕ ( s , a θ ) = Critic 指明的方向 ∂ a ∂ Q ϕ ⋅ Actor 的执行能力 ∂ θ ∂ a θ
为了用优化器最大化 Q Q Q − Q -Q − Q Loss Actor = − Q ϕ ( s , a θ ) \text{Loss}_{\text{Actor}} = -Q_\phi(s, a_\theta) Loss Actor = − Q ϕ ( s , a θ )
SAC
SAC 是一种基于最大熵强化学习 框架的、Off-policy 的 Actor-Critic 深度强化学习算法。
传统的强化学习目标是:“找到一个策略,使期望奖励总和最大化” ,而 SAC 目标是:“找到一个策略,使期望奖励总和最大化的同时,策略的随机性(熵)也最大化” 。目标函数就变成了:
J ( π ) = ∑ t E ( s t , a t ) ∼ π [ r ( s t , a t ) + α H ( π ( ⋅ ∣ s t ) ) ] J(\pi) = \sum_t \mathbb{E}_{(s_t, a_t) \sim \pi} \left[ r(s_t, a_t) + \alpha \mathcal{H}(\pi(\cdot|s_t)) \right] J ( π ) = t ∑ E ( s t , a t ) ∼ π [ r ( s t , a t ) + α H ( π ( ⋅ ∣ s t )) ] SAC 首先将当前状态 s s s a a a a a a r r r s ′ s' s ′ d d d ( s , a , r , s ′ , d ) (s, a, r, s', d) ( s , a , r , s ′ , d ) Replay Buffer ,重复这个过程多次。然后从 Buffer 中随机抽取一个 Batch 的数据来先后更新Critic、Actor、Target Critic 网络,针对每一个 s ′ s' s ′ s ′ s' s ′ a ′ a' a ′ − log π ( a ′ ∣ s ′ ) -\log \pi(a'|s') − log π ( a ′ ∣ s ′ ) min ( Q t a r g 1 ( s ′ , a ′ ) , Q t a r g 2 ( s ′ , a ′ ) ) \min(Q_{targ1}(s', a'), Q_{targ2}(s', a')) min ( Q t a r g 1 ( s ′ , a ′ ) , Q t a r g 2 ( s ′ , a ′ )) y = r + γ ( 1 − d ) [ min ( Q t a r g 1 , 2 ) + α H ] y = r + \gamma (1-d) \left[ \min(Q_{targ1, 2}) + \alpha \mathcal{H} \right] y = r + γ ( 1 − d ) [ min ( Q t a r g 1 , 2 ) + α H ] s s s a a a Q 1 ( s , a ) Q_1(s,a) Q 1 ( s , a ) Q 2 ( s , a ) Q_2(s,a) Q 2 ( s , a ) y y y s s s 通过重参数化采样 得到新动作 a new a_{\text{new}} a new Q 评估 = min ( Q 1 ( s , a new ) , Q 2 ( s , a new ) ) Q_{\text{评估}} = \min(Q_1(s, a_{\text{new}}), Q_2(s, a_{\text{new}})) Q 评估 = min ( Q 1 ( s , a new ) , Q 2 ( s , a new )) Loss actor = − [ Q 评估 − α log π ( a new ∣ s ) ] \text{Loss}_{\text{actor}} = -\left[ Q_{\text{评估}} - \alpha \log \pi(a_{\text{new}}|s) \right] Loss actor = − [ Q 评估 − α log π ( a new ∣ s ) ] soft_update_target_critic(tau)对目标网络软更新,让两个 Target Critic 网络的参数缓慢向当前的 Critic 网络靠近,让训练更加平滑。
SAC 可以看作是 DQN 思想在连续动作空间 的进化版。它用 Actor 解决了连续动作无法 max \max max