Model-based 强化学习 学习transition dynamic来确定如何选择动作,如果我们完全知道运行规律就可以直接用控制论中的算法解决,如
optimal control 选择控制以最优化某些奖励或最小化成本的一类问题
trajectory optimization 轨迹优化是选择一系列状态和动作来优化某个结果的特定问题,可被视为解决最优控制问题的一种方法。
planning 规划通常指的是轨迹优化的离散版本,虽然也可指轨迹规划的连续版本,但在这种情况下两者本质是相同的。不过被称为规划的算法在一种离散分支下会考虑多种可能性,而前者通常执行基于平滑梯度的优化。
Linear Quadratic Regulator
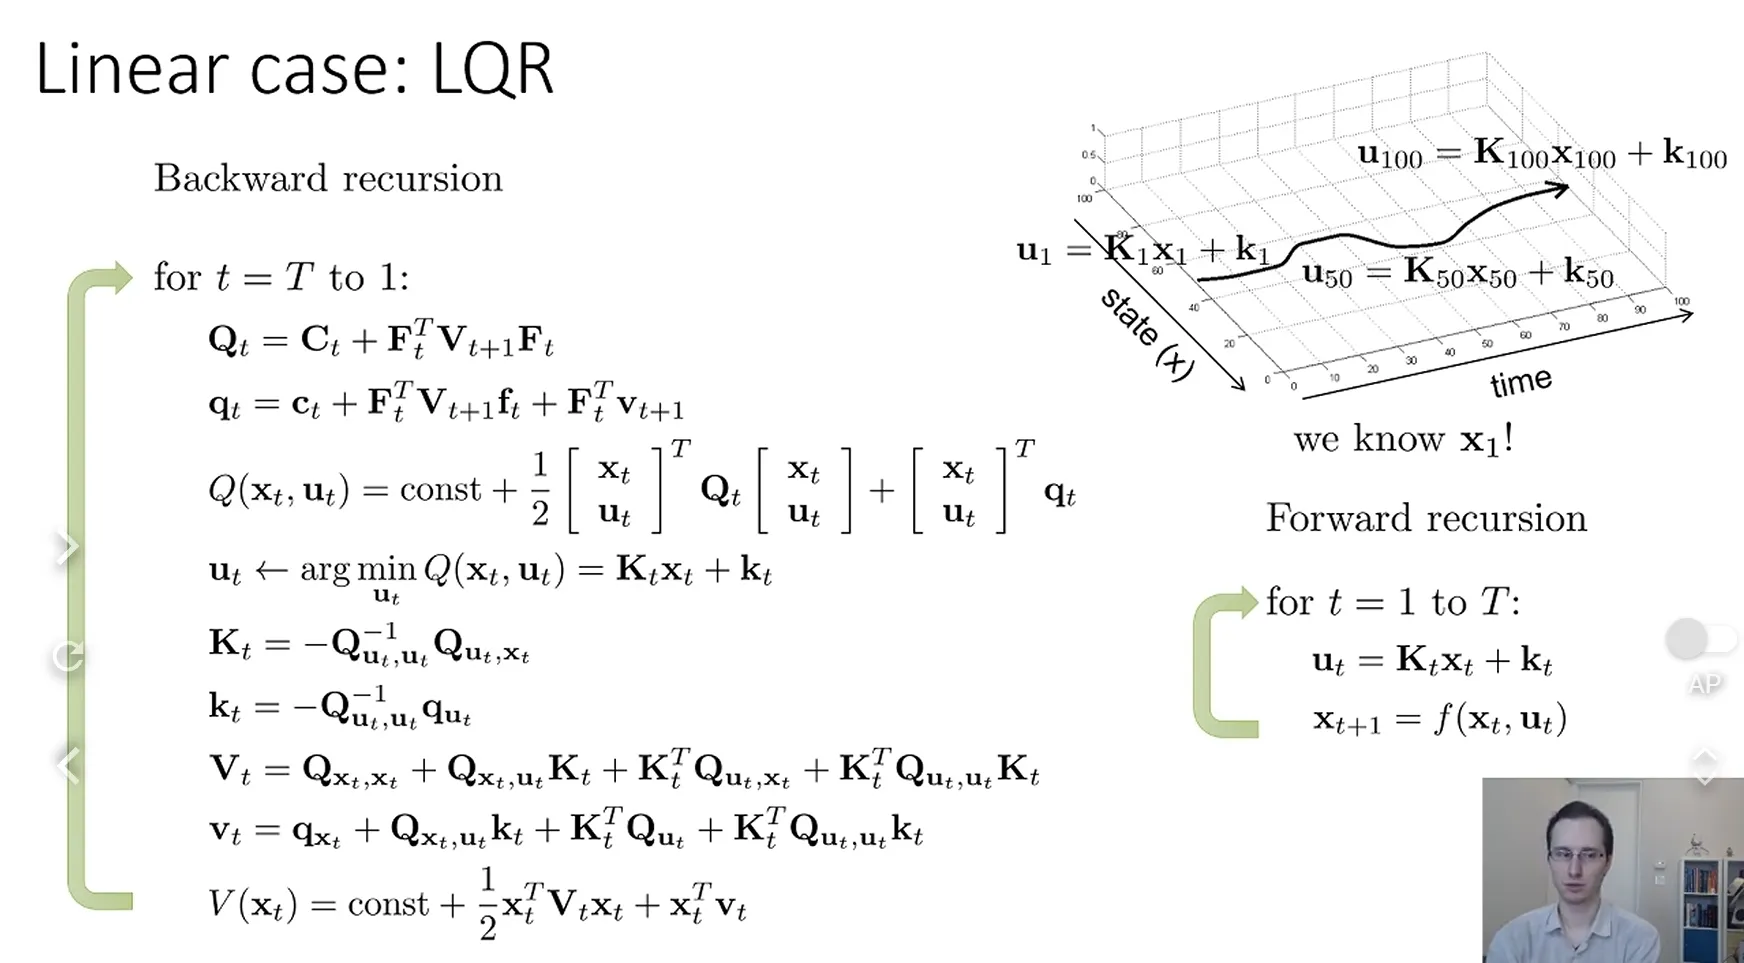
LQR 解决的是在一个系统动力学为线性 、代价函数为二次型 的系统中,如何寻找一组最优的控制序列 u1,…,uT 使得总代价值最小。
原理推导
线性动力学 :
x t + 1 = f ( x t , u t ) = F t [ x t u t ] + f t \mathbf{x}_{t+1} = f(\mathbf{x}_t, \mathbf{u}_t) = \mathbf{F}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \mathbf{f}_t x t + 1 = f ( x t , u t ) = F t [ x t u t ] + f t 二次型代价函数 :
c ( x t , u t ) = 1 2 [ x t u t ] T C t [ x t u t ] + [ x t u t ] T c t + const c c(\mathbf{x}_t, \mathbf{u}_t) = \frac{1}{2} \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^T \mathbf{C}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^T \mathbf{c}_t + \text{const}_c c ( x t , u t ) = 2 1 [ x t u t ] T C t [ x t u t ] + [ x t u t ] T c t + const c
根据贝尔曼最优方程,第 t t t
Q ( x t , u t ) = c ( x t , u t ) + V ( x t + 1 ) Q(\mathbf{x}_t, \mathbf{u}_t) = c(\mathbf{x}_t, \mathbf{u}_t) + V(\mathbf{x}_{t+1}) Q ( x t , u t ) = c ( x t , u t ) + V ( x t + 1 ) 我们将线性动力学 x t + 1 = F t [ x t u t ] + f t \mathbf{x}_{t+1} = \mathbf{F}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \mathbf{f}_t x t + 1 = F t [ x t u t ] + f t V ( x t + 1 ) V(\mathbf{x}_{t+1}) V ( x t + 1 )
V ( x t + 1 ) = 1 2 ( F t [ x t u t ] + f t ) T V t + 1 ( F t [ x t u t ] + f t ) + ( F t [ x t u t ] + f t ) T v t + 1 + const V(\mathbf{x}_{t+1}) = \frac{1}{2} \left( \mathbf{F}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \mathbf{f}_t \right)^T \mathbf{V}_{t+1} \left( \mathbf{F}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \mathbf{f}_t \right) + \left( \mathbf{F}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \mathbf{f}_t \right)^T \mathbf{v}_{t+1} + \text{const} V ( x t + 1 ) = 2 1 ( F t [ x t u t ] + f t ) T V t + 1 ( F t [ x t u t ] + f t ) + ( F t [ x t u t ] + f t ) T v t + 1 + const 我们对上式进行展开,整理成关于 [ x t u t ] \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} [ x t u t ]
V ( x t + 1 ) = 1 2 [ x t u t ] T ( F t T V t + 1 F t ) [ x t u t ] + [ x t u t ] T ( F t T V t + 1 f t + F t T v t + 1 ) + const ′ V(\mathbf{x}_{t+1}) = \frac{1}{2} \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^T \left( \mathbf{F}_t^T \mathbf{V}_{t+1} \mathbf{F}_t \right) \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^T \left( \mathbf{F}_t^T \mathbf{V}_{t+1} \mathbf{f}_t + \mathbf{F}_t^T \mathbf{v}_{t+1} \right) + \text{const}' V ( x t + 1 ) = 2 1 [ x t u t ] T ( F t T V t + 1 F t ) [ x t u t ] + [ x t u t ] T ( F t T V t + 1 f t + F t T v t + 1 ) + const ′ 现在,我们将 c ( x t , u t ) c(\mathbf{x}_t, \mathbf{u}_t) c ( x t , u t ) V ( x t + 1 ) V(\mathbf{x}_{t+1}) V ( x t + 1 ) [ x t u t ] \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} [ x t u t ]
Q ( x t , u t ) = 1 2 [ x t u t ] T Q t [ x t u t ] + [ x t u t ] T q t + const ′ ′ Q(\mathbf{x}_t, \mathbf{u}_t) = \frac{1}{2} \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^T \mathbf{Q}_t \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix} + \begin{bmatrix} \mathbf{x}_t \\ \mathbf{u}_t \end{bmatrix}^T \mathbf{q}_t + \text{const}'' Q ( x t , u t ) = 2 1 [ x t u t ] T Q t [ x t u t ] + [ x t u t ] T q t + const ′′ 其中,新构建的中间矩阵和向量参数为:Q t = C t + F t T V t + 1 F t \mathbf{Q}_t = \mathbf{C}_t + \mathbf{F}_t^T \mathbf{V}_{t+1} \mathbf{F}_t Q t = C t + F t T V t + 1 F t q t = c t + F t T V t + 1 f t + F t T v t + 1 \mathbf{q}_t = \mathbf{c}_t + \mathbf{F}_t^T \mathbf{V}_{t+1} \mathbf{f}_t + \mathbf{F}_t^T \mathbf{v}_{t+1} q t = c t + F t T V t + 1 f t + F t T v t + 1
为了找出使 Q ( x t , u t ) Q(\mathbf{x}_t, \mathbf{u}_t) Q ( x t , u t ) u t \mathbf{u}_t u t u t \mathbf{u}_t u t
Q ( x t , u t ) = const + 1 2 u t T Q u t , u t u t + u t T Q u t , x t x t + u t T q u t Q(\mathbf{x}_t, \mathbf{u}_t) = \text{const} + \frac{1}{2} \mathbf{u}_t^T \mathbf{Q}_{\mathbf{u}_t, \mathbf{u}_t} \mathbf{u}_t + \mathbf{u}_t^T \mathbf{Q}_{\mathbf{u}_t, \mathbf{x}_t} \mathbf{x}_t + \mathbf{u}_t^T \mathbf{q}_{\mathbf{u}_t} Q ( x t , u t ) = const + 2 1 u t T Q u t , u t u t + u t T Q u t , x t x t + u t T q u t 对控制变量 u t \mathbf{u}_t u t
∇ u t Q ( x t , u t ) = Q u t , u t u t + Q u t , x t x t + q u t = 0 \nabla_{\mathbf{u}_t} Q(\mathbf{x}_t, \mathbf{u}_t) = \mathbf{Q}_{\mathbf{u}_t, \mathbf{u}_t} \mathbf{u}_t + \mathbf{Q}_{\mathbf{u}_t, \mathbf{x}_t} \mathbf{x}_t + \mathbf{q}_{\mathbf{u}_t} = 0 ∇ u t Q ( x t , u t ) = Q u t , u t u t + Q u t , x t x t + q u t = 0 解出最优控制决策,呈现为线性状态反馈控制:u t ∗ = K t x t + k t \mathbf{u}_t^* = \mathbf{K}_t \mathbf{x}_t + \mathbf{k}_t u t ∗ = K t x t + k t
其中,控制增益矩阵 K t \mathbf{K}_t K t k t \mathbf{k}_t k t K t = − Q u t , u t − 1 Q u t , x t \mathbf{K}_t = -\mathbf{Q}_{\mathbf{u}_t, \mathbf{u}_t}^{-1} \mathbf{Q}_{\mathbf{u}_t, \mathbf{x}_t} K t = − Q u t , u t − 1 Q u t , x t k t = − Q u t , u t − 1 q u t \mathbf{k}_t = -\mathbf{Q}_{\mathbf{u}_t, \mathbf{u}_t}^{-1}\mathbf{q}_{\mathbf{u}_t} k t = − Q u t , u t − 1 q u t
我们将最优策略 u t ∗ = K t x t + k t \mathbf{u}_t^* = \mathbf{K}_t \mathbf{x}_t + \mathbf{k}_t u t ∗ = K t x t + k t Q ( x t , u t ) Q(\mathbf{x}_t, \mathbf{u}_t) Q ( x t , u t )
V ( x t ) = min u t Q ( x t , u t ) = Q ( x t , K t x t + k t ) V(\mathbf{x}_t) = \min_{\mathbf{u}_t} Q(\mathbf{x}_t, \mathbf{u}_t) = Q(\mathbf{x}_t, \mathbf{K}_t \mathbf{x}_t + \mathbf{k}_t) V ( x t ) = u t min Q ( x t , u t ) = Q ( x t , K t x t + k t ) 展开该代入式:
V ( x t ) = const + 1 2 [ x t K t x t + k t ] T [ Q x t , x t Q x t , u t Q u t , x t Q u t , u t ] [ x t K t x t + k t ] + [ x t K t x t + k t ] T [ q x t q u t ] V(\mathbf{x}_t) = \text{const} + \frac{1}{2} \begin{bmatrix} \mathbf{x}_t \\ \mathbf{K}_t \mathbf{x}_t + \mathbf{k}_t \end{bmatrix}^T \begin{bmatrix} \mathbf{Q}_{\mathbf{x}_t, \mathbf{x}_t} & \mathbf{Q}_{\mathbf{x}_t, \mathbf{u}_t} \\ \mathbf{Q}_{\mathbf{u}_t, \mathbf{x}_t} & \mathbf{Q}_{\mathbf{u}_t, \mathbf{u}_t} \end{bmatrix} \begin{bmatrix} \mathbf{x}_t \\ \mathbf{K}_t \mathbf{x}_t + \mathbf{k}_t \end{bmatrix} + \begin{bmatrix} \mathbf{x}_t \\ \mathbf{K}_t \mathbf{x}_t + \mathbf{k}_t \end{bmatrix}^T \begin{bmatrix} \mathbf{q}_{\mathbf{x}_t} \\ \mathbf{q}_{\mathbf{u}_t} \end{bmatrix} V ( x t ) = const + 2 1 [ x t K t x t + k t ] T [ Q x t , x t Q u t , x t Q x t , u t Q u t , u t ] [ x t K t x t + k t ] + [ x t K t x t + k t ] T [ q x t q u t ] 我们将上式完全展开,并分别合并关于 x t \mathbf{x}_t x t t t t
V ( x t ) = 1 2 x t T V t x t + x t T v t + const V(\mathbf{x}_t) = \frac{1}{2} \mathbf{x}_t^T \mathbf{V}_t \mathbf{x}_t + \mathbf{x}_t^T \mathbf{v}_t + \text{const} V ( x t ) = 2 1 x t T V t x t + x t T v t + const 其中:V t = Q x t , x t + Q x t , u t K t + K t T Q u t , x t + K t T Q u t , u t K t \mathbf{V}_t = \mathbf{Q}_{\mathbf{x}_t, \mathbf{x}_t} + \mathbf{Q}_{\mathbf{x}_t, \mathbf{u}_t} \mathbf{K}_t + \mathbf{K}_t^T \mathbf{Q}_{\mathbf{u}_t, \mathbf{x}_t} + \mathbf{K}_t^T \mathbf{Q}_{\mathbf{u}_t, \mathbf{u}_t} \mathbf{K}_t V t = Q x t , x t + Q x t , u t K t + K t T Q u t , x t + K t T Q u t , u t K t v t = q x t + Q x t , u t k t + K t T q u t + K t T Q u t , u t k t \mathbf{v}_t = \mathbf{q}_{\mathbf{x}_t} + \mathbf{Q}_{\mathbf{x}_t, \mathbf{u}_t} \mathbf{k}_t + \mathbf{K}_t^T \mathbf{q}_{\mathbf{u}_t} + \mathbf{K}_t^T \mathbf{Q}_{\mathbf{u}_t, \mathbf{u}_t} \mathbf{k}_t v t = q x t + Q x t , u t k t + K t T q u t + K t T Q u t , u t k t
状态价值函数在 t t t V t , v t \mathbf{V}_t, \mathbf{v}_t V t , v t t + 1 t+1 t + 1 t = T t=T t = T T T T T + 1 T+1 T + 1 V T + 1 = 0 , v T + 1 = 0 \mathbf{V}_{T+1} = \mathbf{0}, \quad \mathbf{v}_{T+1} = \mathbf{0} V T + 1 = 0 , v T + 1 = 0 t = T t=T t = T Q T = C T , q T = c T \mathbf{Q}_T = \mathbf{C}_T,\mathbf{q}_T = \mathbf{c}_T Q T = C T , q T = c T
具体步骤如图
Iterative LQR 与 DDP
虽然世界是高度非线性的,但在实际工程中,我们不需要系统整体是线性的,只需要它在某个局部是线性的即可 ,而通过泰勒展开就可以把非线性系统近似为线性系统。利用这个原理,我们就有了 iLQR 算法。
先提供一个粗糙的、猜测的参考轨迹,然后不直接求解绝对的 x t x_t x t u t u_t u t 局部动力学线性化 和代价二次型化 。运行 LQR 双向递推算法计算出偏差调整量,然后用这个偏差量去正向模拟生成新轨迹。如果新总代价小于旧基准轨迹的总代价,就接受这条新轨迹。如果新总代价大于旧总代价,就减小线搜索参数 α (防止迈的步子太大导致发散)重新跑一遍模拟,直到代价值确实下降了。将这次成功降低了代价的新轨迹,作为下一轮迭代的参考轨迹。
iLQR 本质上是轨迹优化领域的高斯—牛顿近似法,由于忽略动力学的二阶导数项,它通常比完整 DDP 更易实现和计算。DDP 保留这些二阶项,可视为更接近牛顿法的二阶轨迹优化方法。它的计算成本更高,因此在工程中使用相对较少,但在二阶精度重要的场景中仍有价值。
但是在有限的计算资源下我们不能规划无限长步数,如何处理终端条件是一个问题。
TD-MPC 算法
利用 Model-Free的时序差分学习TD Learning训练一个价值网络 V ^ θ ( s ) \hat{V}_\theta(\mathbf{s}) V ^ θ ( s ) H H H H + 1 H+1 H + 1 V t + H ( s t + H ) = V ^ θ ( s t + H ) V_{t+H}(\mathbf{s}_{t+H}) = \hat{V}_\theta(\mathbf{s}_{t+H}) V t + H ( s t + H ) = V ^ θ ( s t + H )
代数里卡蒂方程(Algebraic Riccati Equation, ARE)
在 MPC 规划时,用 ARE 求解出的状态价值矩阵 V ∞ \mathbf{V}_{\infty} V ∞ t + H t+H t + H V t + H ( x t + H ) = 1 2 x t + H T V ∞ x t + H V_{t+H}(\mathbf{x}_{t+H}) = \frac{1}{2} \mathbf{x}_{t+H}^T \mathbf{V}_{\infty} \mathbf{x}_{t+H} V t + H ( x t + H ) = 2 1 x t + H T V ∞ x t + H Q ⪰ 0 \mathbf{Q}\succeq 0 Q ⪰ 0 R ≻ 0 \mathbf{R}\succ 0 R ≻ 0 ( A , B ) (\mathbf{A},\mathbf{B}) ( A , B ) ( Q 1 / 2 , A ) (\mathbf{Q}^{1/2},\mathbf{A}) ( Q 1/2 , A )
Terminal Penalty
在第 t + H t+H t + H Q terminal \mathbf{Q}_{\text{terminal}} Q terminal V t + H ( x t + H ) = 1 2 x t + H T Q terminal x t + H V_{t+H}(\mathbf{x}_{t+H}) = \frac{1}{2} \mathbf{x}_{t+H}^T \mathbf{Q}_{\text{terminal}} \mathbf{x}_{t+H} V t + H ( x t + H ) = 2 1 x t + H T Q terminal x t + H
uncertainty-aware model
在缺少训练数据的未知区域会出现 distribution mismatch,单个神经网络可能给出错误且过度自信的预测,它输出的 aleatoric uncertainty σ 2 \sigma^2 σ 2
模型集成(训练多个不同的神经网络) 。
在某个区域,多个动力学网络之间的预测分歧可以用于近似估计认知不确定性。PETS 在规划时传播 ensemble 表达的不确定性,通常能提高预测可靠性和样本效率。结合保守或风险敏感的评价方式,可以减少规划器进入数据不足区域的倾向。但模型分歧只是 epistemic uncertainty 的近似,不能保证 OOD 校准、安全性或收敛。随着网络数量增加计算量也会增加,实践中通常使用规模不大的 ensemble。
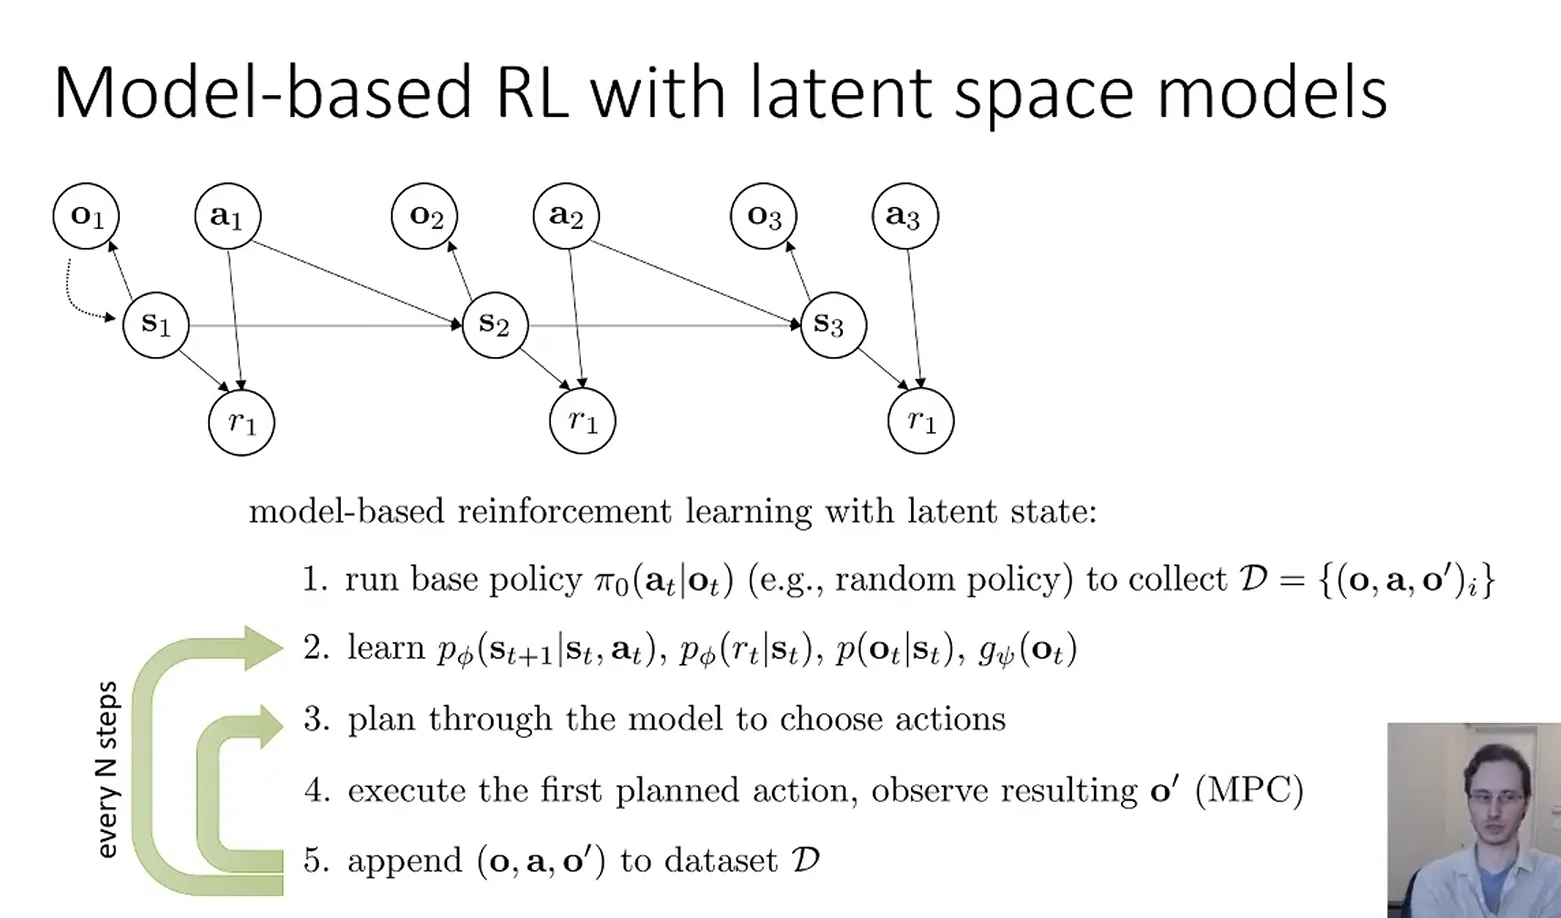
model-based rl with latent space model
Deterministic Encoder :
它将一张高维图像 o t \mathbf{o}_t o t 64 × 64 64 \times 64 64 × 64 s t = g ψ ( o t ) \mathbf{s}_t = g_\psi(\mathbf{o}_t) s t = g ψ ( o t ) Stochastic Encoder :
它不直接输出一个固定的点,而是将图像 o t \mathbf{o}_t o t 一个概率分布(通常是高斯分布) :
s t ∼ q ψ ( s t ∣ o t ) = N ( μ ψ ( o t ) , σ ψ 2 ( o t ) ) \mathbf{s}_t \sim q_\psi(\mathbf{s}_t | \mathbf{o}_t) = \mathcal{N}\left( \mu_\psi(\mathbf{o}_t), \sigma^2_\psi(\mathbf{o}_t) \right) s t ∼ q ψ ( s t ∣ o t ) = N ( μ ψ ( o t ) , σ ψ 2 ( o t ) ) 均值 μ ψ \mu_\psi μ ψ σ ψ 2 \sigma^2_\psi σ ψ 2 ,通过在这个分布中进行采样,得到具体的隐状态 s t \mathbf{s}_t s t
用编码器将图像压缩到低维的隐空间 s t \mathbf{s}_t s t
Encoder(编码器) g ψ g_\psi g ψ :输入当前图像 o t \mathbf{o}_t o t s t \mathbf{s}_t s t Latent Dynamics(隐空间动力学模型) p ϕ p_\phi p ϕ :在隐空间内预测下一步,输入当前隐状态 s t \mathbf{s}_t s t a t \mathbf{a}_t a t s t + 1 \mathbf{s}_{t+1} s t + 1 Decoder(解码器) p ϕ p_\phi p ϕ :输入 s t \mathbf{s}_t s t o t \mathbf{o}_t o t Reward Model(奖励模型) p ϕ p_\phi p ϕ :输入 s t \mathbf{s}_t s t r t r_t r t
收集了一批包含图像、动作、奖励的轨迹数据,通过最大化联合似然损失函数 来同时训练所有网络的参数 ϕ \phi ϕ ψ \psi ψ
max ϕ , ψ ∑ [ log p ϕ ( g ψ ( o t + 1 ) ∣ g ψ ( o t ) , a t ) ⏟ 1. 隐空间动力学损失 + log p ϕ ( o t ∣ g ψ ( o t ) ) ⏟ 2. 图像重构损失 + log p ϕ ( r t ∣ g ψ ( o t ) ) ⏟ 3. 奖励预测损失 ] \max_{\phi, \psi} \sum \Big[ \underbrace{\log p_\phi(g_\psi(\mathbf{o}_{t+1}) | g_\psi(\mathbf{o}_t), \mathbf{a}_t)}_{\text{1. 隐空间动力学损失}} + \underbrace{\log p_\phi(\mathbf{o}_t | g_\psi(\mathbf{o}_t))}_{\text{2. 图像重构损失}} + \underbrace{\log p_\phi(r_t | g_\psi(\mathbf{o}_t))}_{\text{3. 奖励预测损失}} \Big] max ϕ , ψ ∑ [ 1. 隐空间动力学损失 log p ϕ ( g ψ ( o t + 1 ) ∣ g ψ ( o t ) , a t ) + 2. 图像重构损失 log p ϕ ( o t ∣ g ψ ( o t )) + 3. 奖励预测损失 log p ϕ ( r t ∣ g ψ ( o t )) ]
如果是随机编码器,通常还会加入 KL 散度,将后验隐藏分布约束到动作条件 latent prior。在简单 VAE 中,这个先验也可能直接取标准高斯分布。
运行一个基础的探索策略 π 0 \pi_0 π 0 D \mathcal{D} D D = { ( o t , a t , o t + 1 , r t ) i } \mathcal{D} = \{ (\mathbf{o}_t, \mathbf{a}_t, \mathbf{o}_{t+1}, r_t)_i \} D = {( o t , a t , o t + 1 , r t ) i }
在数据集 D \mathcal{D} D ϕ , ψ \phi, \psi ϕ , ψ
面临当前的真实图片 o t \mathbf{o}_t o t s t = g ψ ( o t ) \mathbf{s}_t = g_\psi(\mathbf{o}_t) s t = g ψ ( o t ) 在低维隐空间内 ,利用隐动力学模型 p ϕ p_\phi p ϕ H H H a t ∗ , … , a t + H − 1 ∗ \mathbf{a}_t^*, \dots, \mathbf{a}_{t+H-1}^* a t ∗ , … , a t + H − 1 ∗
只在真实物理世界中执行第一步动作 a t ∗ \mathbf{a}_t^* a t ∗ o t + 1 \mathbf{o}_{t+1} o t + 1 r t r_t r t
将新产生的这一步真实交互数据 ( o t , a t , o t + 1 , r t ) (\mathbf{o}_t, \mathbf{a}_t, \mathbf{o}_{t+1}, r_t) ( o t , a t , o t + 1 , r t ) D \mathcal{D} D
learn directly from observation space
这类方法在更复杂的场景中效果很好,因为在这些场景中学习紧凑的潜在空间非常困难。例如,如果场景中有几十个物体,如何为他们构建一个紧凑的状态空间就很难说清楚了。此时在图像空间进行预测却非常有效,可以指示机器人执行特定操作。
model-based policy learning
通过模型进行在线规划
不显式地训练一个策略网络,而是直接利用学好的模型 f ϕ f_ϕ f ϕ MPC(模型预测控制) 算法,当机器人处于状态 s t s_t s t f ϕ f_ϕ f ϕ
通过模型进行梯度反向传播
如果拟合的环境模型 f ϕ ( s , a ) f_\phi(s, a) f ϕ ( s , a ) 穿过环境模型 ,直接反向传播给策略网络。
∇ θ Reward = ∂ Reward ∂ s t + 1 ⋅ ∂ f ϕ ( s t , a t ) ∂ a t ⏟ 环境模型的梯度 ⋅ ∂ π θ ( s t ) ∂ θ ⏟ 策略网络的梯度 \nabla_\theta \text{Reward} = \frac{\partial \text{Reward}}{\partial s_{t+1}} \cdot \underbrace{\frac{\partial f_\phi(s_t, a_t)}{\partial a_t}}_{\text{环境模型的梯度}} \cdot \underbrace{\frac{\partial \pi_\theta(s_t)}{\partial \theta}}_{\text{策略网络的梯度}} ∇ θ Reward = ∂ s t + 1 ∂ Reward ⋅ 环境模型的梯度 ∂ a t ∂ f ϕ ( s t , a t ) ⋅ 策略网络的梯度 ∂ θ ∂ π θ ( s t ) PILCO 通过 GP 预测分布解析地计算近似期望回报的梯度,SVG 使用 stochastic value gradients 迭代优化策略。对于可微的确定性模型,将梯度穿过 T T T f ϕ ( s , a ) f_\phi(\mathbf{s}, \mathbf{a}) f ϕ ( s , a ) T T T 1 1 1
J t = ∂ f ϕ ∂ s t + ∂ f ϕ ∂ a t ∂ π θ ∂ s t , ∂ s T ∂ s 1 = J T − 1 J T − 2 ⋯ J 1 \mathbf{J}_t = \frac{\partial f_\phi}{\partial \mathbf{s}_t} + \frac{\partial f_\phi}{\partial \mathbf{a}_t}\frac{\partial \pi_\theta}{\partial \mathbf{s}_t}, \qquad
\frac{\partial \mathbf{s}_T}{\partial \mathbf{s}_1} = \mathbf{J}_{T-1}\mathbf{J}_{T-2}\cdots\mathbf{J}_1 J t = ∂ s t ∂ f ϕ + ∂ a t ∂ f ϕ ∂ s t ∂ π θ , ∂ s 1 ∂ s T = J T − 1 J T − 2 ⋯ J 1 长 horizon 的直接反向传播容易受到模型偏差以及梯度消失或爆炸的影响,系统中的非光滑接触也可能使梯度不稳定。因此它在复杂动力系统中较难使用,但并非普遍无效:短 horizon、latent model、value bootstrap、正则化和更好的可微模型都可能使这种方法有效。
solution:model-free learning with a model
Dyna & MBPO
训练一个环境动力学模型 p ^ ( s ′ ∣ s , a ) \hat{p}(s'|s, a) p ^ ( s ′ ∣ s , a ) Model-Free 算法 (如 Q-learning、SAC 或 PPO)。这些学习器不需要将梯度穿过动力学模型:以 SAC 为例,critic 更新只对 Q Q Q Q Q Q ∂ f ∂ a \frac{\partial f}{\partial a} ∂ a ∂ f
LQR-FLM & GPS
我们不用神经网络直接去学复杂的 RL 策略,相反,我们在多个简单的局部路径上,运行 LQR 算法 训练局部线性策略,再通过监督学习合成全局网络 。
让线性高斯控制器在真实机器人上运行p ( u t ∣ x t ) = N ( K t x t + k t , Σ t ) p(\mathbf{u}_t|\mathbf{x}_t) = \mathcal{N}(\mathbf{K}_t \mathbf{x}_t + \mathbf{k}_t, \boldsymbol{\Sigma}_t) p ( u t ∣ x t ) = N ( K t x t + k t , Σ t ) D = { τ i } \mathcal{D} = \{\tau_i\} D = { τ i } t t t 线性回归(最小二乘法)来拟合局部的线性时变动力学系统
p ( x t + 1 ∣ x t , u t ) = N ( A t x t + B t u t , Σ ) p(\mathbf{x}_{t+1}|\mathbf{x}_t, \mathbf{u}_t) = \mathcal{N}(\mathbf{A}_t \mathbf{x}_t + \mathbf{B}_t \mathbf{u}_t, \boldsymbol{\Sigma}) p ( x t + 1 ∣ x t , u t ) = N ( A t x t + B t u t , Σ ) A t ≈ ∂ f ∂ x t , B t ≈ ∂ f ∂ u t \mathbf{A}_t \approx \frac{\partial f}{\partial \mathbf{x}_t}, \quad \mathbf{B}_t \approx \frac{\partial f}{\partial \mathbf{u}_t} A t ≈ ∂ x t ∂ f , B t ≈ ∂ u t ∂ f A t , B t \mathbf{A}_t, \mathbf{B}_t A t , B t LQR 逆向递推算法 ,一步到位、瞬间 计算出新的一组更优的反馈增益和偏置参数:K t new , k t new \mathbf{K}_t^{\text{new}}, \quad \mathbf{k}_t^{\text{new}} K t new , k t new p new ( u t ∣ x t ) = N ( K t new x t + k t new , Σ t ) p_{\text{new}}(\mathbf{u}_t|\mathbf{x}_t) = \mathcal{N}(\mathbf{K}_t^{\text{new}} \mathbf{x}_t + \mathbf{k}_t^{\text{new}}, \boldsymbol{\Sigma}_t) p new ( u t ∣ x t ) = N ( K t new x t + k t new , Σ t ) improve controller 这一步,通过施加数学约束(例如 限制新旧控制器之间的 KL 散度 ),强制规定新策略与旧策略在概率分布上不能偏离太远。这确保了机器人产生的新轨迹依然落在局部模型的有效范围内。
GPS(Guided Policy Search) 会在空间中不同的起始点上,运行多个不同的 LQR-FLM 实例,生产出多条不同的局部标准答案。然后,GPS 开启一个监督学习 过程,训练一个神经网络 πθ(a∣o)去同时模仿所有这些局部 LQR-FLM 产生的数据,得到复杂的全局政策网络。
在局部线性动力学与二次代价近似有效、相关矩阵可逆的条件下,有限时域 LQR 可以通过 Riccati 逆向递推高效求得局部最优控制轨迹,无需对整个系统动力学进行长时序 BPTT。局部动力学模型可通过带正则化的最小二乘稳定估计,并在设计矩阵满秩时具有唯一闭式解。随后利用这些轨迹监督训练全局策略,通常比直接进行长时序强化学习或端到端轨迹优化更容易,但仍不保证局部模型准确、全局策略收敛或部署时稳定。
HW4
误差传播机制
如果建立的环境模型有一点点不准,或者神经网络有一点点误差,当智能体在环境里连续跑 100 步时,这个误差会怎么放大?在固定策略 π \pi π P π P^\pi P π P ^ π \hat P^\pi P ^ π Q π − Q ^ π = γ ( I − γ P ^ π ) − 1 ( P π − P ^ π ) Q π . Q^\pi-\hat Q^\pi=\gamma(I-\gamma\hat P^\pi)^{-1}(P^\pi-\hat P^\pi)Q^\pi. Q π − Q ^ π = γ ( I − γ P ^ π ) − 1 ( P π − P ^ π ) Q π .
从 Simulation Lemma 我们可以知道,要减小全局误差 Q − Q ^ Q - \hat{Q} Q − Q ^
**降低单步误差 ( P − P ^ ) (P - \hat{P}) ( P − P ^ )
控制价值函数的尺度或平滑性 :V V V V V V
统计独立性陷阱
当使用 N N N P ^ \hat{P} P ^ P P P V V V 固定 的有界函数(比如真实的最优价值 V ∗ V^* V ∗ ( P ^ − P ) V (\hat P-P)V ( P ^ − P ) V 1 N \frac{1}{\sqrt{N}} N 1 V V V 在同一个数据集上训练出来的神经网络输出 V ^ \hat{V} V ^ ,那么它们在统计上就会产生了强烈的相互依赖,不能直接套用固定函数版本的集中不等式,需要用数据分割、一致收敛等方法处理数据依赖。
诺依曼级数
( I − γ P π ) − 1 = I + γ P π + γ 2 ( P π ) 2 + … (I - \gamma P^\pi)^{-1} = I + \gamma P^\pi + \gamma^2 (P^\pi)^2 + \dots ( I − γ P π ) − 1 = I + γ P π + γ 2 ( P π ) 2 + …
I I I γ P π \gamma P^\pi γ P π γ 2 ( P π ) 2 \gamma^2(P^\pi)^2 γ 2 ( P π ) 2 π \pi π
Successor Features
假设环境的单步期望奖励可以写成r ( s , a , s ′ ) = ϕ ( s , a , s ′ ) T w r(s,a,s') = \boldsymbol{\phi}(s,a,s')^T \mathbf{w} r ( s , a , s ′ ) = ϕ ( s , a , s ′ ) T w ϕ ( s , a ) \boldsymbol{\phi}(s, a) ϕ ( s , a ) w \mathbf{w} w Q Q Q Q π ( s , a ) = E [ ∑ γ t ϕ t ] T w = ψ π ( s , a ) T w Q^\pi(s,a) = \mathbb{E} \left[ \sum \gamma^t \boldsymbol{\phi}_t \right]^T \mathbf{w} = \boldsymbol{\psi}^\pi(s,a)^T \mathbf{w} Q π ( s , a ) = E [ ∑ γ t ϕ t ] T w = ψ π ( s , a ) T w ψ π ( s , a ) \boldsymbol{\psi}^\pi(s,a) ψ π ( s , a ) k k k π \pi π k k k ψ π = ( I − γ P π ) − 1 ϕ \boldsymbol{\psi}^\pi = (I - \gamma P^\pi)^{-1} \boldsymbol{\phi} ψ π = ( I − γ P π ) − 1 ϕ
假设特征 ϕ t = ϕ ( s t , a t , s t + 1 ) \phi_t=\phi(s_t,a_t,s_{t+1}) ϕ t = ϕ ( s t , a t , s t + 1 ) ϕ \phi ϕ ϕ \phi ϕ ϕ \phi ϕ
\mathbb E
\left[
\left(
r_{t+1}-\phi_t^\top\hat w
\right)^2
\right],再类比 Q − l e a r n i n g 用标准的 M o d e l − F r e e T D − l e a r n i n g 去训练 S F 网络 ,再类比 Q-learning 用标准的 Model-Free TD-learning 去训练 SF 网络 ,再类比 Q − l e a r nin g 用标准的 M o d e l − F r ee T D − l e a r nin g 去训练 S F 网络 ψ π \psi^\pi ψ π π \pi π
FB Representation
如果说 SF 解耦了固定策略下的未来特征占用和奖励权重,那么 **FB Representation 学习的是随任务表征 z z z M π z ( s , a , d s ˉ , d a ˉ ) ≈ F ( s , a , z ) ⊤ B ( s ˉ , a ˉ ) ρ ( d s ˉ , d a ˉ ) M^{\pi_z}
(s,a,d\bar s,d\bar a)
\approx
F(s,a,z)^\top
B(\bar s,\bar a)\,
\rho(d\bar s,d\bar a) M π z ( s , a , d s ˉ , d a ˉ ) ≈ F ( s , a , z ) ⊤ B ( s ˉ , a ˉ ) ρ ( d s ˉ , d a ˉ )
Forward 编码器 F ( s , a , z ) \mathbf{F}(s, a,z) F ( s , a , z ) :表示从当前 ( s , a ) (s,a) ( s , a ) π z \pi_z π z Backward 编码器 B ( s ˉ , a ˉ ) \mathbf{B}(\bar s,\bar a) B ( s ˉ , a ˉ ) :为未来可能访问的目标状态—动作提供一个潜在特征基底F ⊤ B F^⊤B F ⊤ B
先随机初始化两个网络 F θ ( s , a , z ) ∈ R d , B ω ( s , a ) ∈ R d F_\theta(s,a,z)\in\mathbb R^d,B_\omega(s,a)\in\mathbb R^d F θ ( s , a , z ) ∈ R d , B ω ( s , a ) ∈ R d F θ − , B ω − F_{\theta^-},B_{\omega^-} F θ − , B ω −
FB 的目标不是预测下一状态,而是使 F ( s , a , z ) ⊤ B ( s ˉ , a ˉ ) F(s,a,z)^\top B(\bar s,\bar a) F ( s , a , z ) ⊤ B ( s ˉ , a ˉ ) ( s , a ) (s,a) ( s , a ) π z \pi_z π z ( s ˉ , a ˉ ) (\bar s,\bar a) ( s ˉ , a ˉ ) π z ( s ) = arg max a F ( s , a , z ) ⊤ z
\pi_z(s) = \arg\max_a F(s,a,z)^\top z π z ( s ) = arg max a F ( s , a , z ) ⊤ z F θ − F_{\theta^-} F θ −
然后收集 reward-free transition,每个 episode 使用一个经过缩放的随机分布采样 z z z z ∼ ν z\sim\nu z ∼ ν F θ ( s , a , z ) ⊤ z F_\theta(s,a,z)^\top z F θ ( s , a , z ) ⊤ z ε \varepsilon ε ( s t , a t , s t + 1 ) (s_t,a_t,s_{t+1}) ( s t , a t , s t + 1 ) D \mathcal D D
每次 SGD 更新需要三组数据,从 replay buffer 采真实一步 transition { ( s i , a i , s i + 1 ) } i = 1 b \{(s_i,a_i,s_{i+1})\}_{i=1}^{b} {( s i , a i , s i + 1 ) } i = 1 b 另外独立采样 一组查询状态—动作 { ( s ˉ j , a ˉ j ) } j = 1 b \{(\bar s_j,\bar a_j)\}_{j=1}^{b} {( s ˉ j , a ˉ j ) } j = 1 b z i ∼ ν
z_i\sim\nu z i ∼ ν i i i j j j
C i j = F θ ( s i , a i , z i ) ⊤ B ω ( s ˉ j , a ˉ j ) C_{ij} = F_\theta(s_i,a_i,z_i)^\top B_\omega(\bar s_j,\bar a_j) C ij = F θ ( s i , a i , z i ) ⊤ B ω ( s ˉ j , a ˉ j )
C i j C_{ij} C ij i i i z i z_i z i j j j
注意它不是概率严格意义上的单步 transition P ( s ˉ j ∣ s i , a i )
P(\bar s_j\mid s_i,a_i) P ( s ˉ j ∣ s i , a i ) t = 0 , 1 , 2 , … t=0,1,2,\ldots t = 0 , 1 , 2 , …
真实 transition 给了 s i → a i s i + 1
s_i \xrightarrow{a_i} s_{i+1} s i a i s i + 1 s i + 1 s_{i+1} s i + 1 π z i \pi_{z_i} π z i
训练时定义:
π z i ( a ∣ s i + 1 ) = softmax ( F θ − ( s i + 1 , a , z i ) ⊤ z i τ ) \pi_{z_i}(a\mid s_{i+1}) = \operatorname{softmax} \left( \frac{ F_{\theta^-}(s_{i+1},a,z_i)^\top z_i }{\tau} \right) π z i ( a ∣ s i + 1 ) = softmax ( τ F θ − ( s i + 1 , a , z i ) ⊤ z i ) 然后定义
T i j = γ ∑ a ∈ A π z i ( a ∣ s i + 1 ) F θ − ( s i + 1 , a , z i ) ⊤ B ω − ( s ˉ j , a ˉ j ) T_{ij} = \gamma \sum_{a\in\mathcal A} \pi_{z_i}(a\mid s_{i+1}) F_{\theta^-}(s_{i+1},a,z_i)^\top B_{\omega^-}(\bar s_j,\bar a_j) T ij = γ a ∈ A ∑ π z i ( a ∣ s i + 1 ) F θ − ( s i + 1 , a , z i ) ⊤ B ω − ( s ˉ j , a ˉ j ) 也就是现在从 ( s i , a i ) (s_i,a_i) ( s i , a i ) j j j s i + 1 s_{i+1} s i + 1 π z i \pi_{z_i} π z i ( F θ − , B ω − ) (F_{\theta^-},B_{\omega^-}) ( F θ − , B ω − )
L F B = 1 2 b 2 ∑ i , j ( C i j − T i j ) 2 − 1 b ∑ i F θ ( s i , a i , z i ) ⊤ B ω ( s i , a i ) \mathcal L_{\mathrm{FB}} = \frac{1}{2b^2} \sum_{i,j} (C_{ij}-T_{ij})^2 - \frac1b \sum_i F_\theta(s_i,a_i,z_i)^\top B_\omega(s_i,a_i) L FB = 2 b 2 1 i , j ∑ ( C ij − T ij ) 2 − b 1 i ∑ F θ ( s i , a i , z i ) ⊤ B ω ( s i , a i ) 第二项是为了避免 F=B=0 的情况,同时因为 FB 解不是唯一的,可以用任意可逆矩阵改变 F,B,而保持表示的 successor density 不变,所以需要再加上一个 L r e g ≈ ∣ ∣ E ρ [ B B ⊤ ] − I ∣ ∣ F 2 L_{reg}≈||Eρ[BB⊤]−I||_F^2 L r e g ≈ ∣∣ E ρ [ B B ⊤ ] − I ∣ ∣ F 2 E ρ [ B B ⊤ ] ≈ I Eρ[BB⊤]≈I E ρ [ B B ⊤ ] ≈ I
最后 Polyak averaging 更新 target networks:$$
\theta^- \leftarrow \alpha\theta^-+(1-\alpha)\theta, \omega^- \leftarrow \alpha\omega^-+(1-\alpha)\omega
第二阶段根据指定任务给出相应的奖励函数 $r(s,a)$,再把奖励通过 Backward 网络,$B(s',a')$是 FB 通过无奖励训练学出的 backward feature basis,用来表示未来状态—动作,并将后验奖励投影到任务向量空间,变成了一个具体的任务向量 :$$z_r
=
\mathbb E_{(\bar s,\bar a)\sim\rho}
\left[
r(\bar s,\bar a)
B(\bar s,\bar a)
\right]$$。例如到达目标 $(s_g,a_g)$ 这种单点奖励,可以直接设置:$$
z_r=B(s_g,a_g)$$不一定需要手工设计复杂的稠密奖励。
第三阶段拿到了翻译好的真实任务向量 ,$z_r$ 后把未来特征和目标权重 $z_r$ 做个内积 $$Q_r(s,a) = F(s,a,z_r)^T z_r$$,算出估计 $Q$ 值,最后直接 $\arg\max_a$ 选出最大的动作。
FB 不显式预测下一状态或重建像素,而是在隐空间中学习策略条件下的长期折扣占用结构。该结构可以在动力学不变时复用于大量后验奖励任务,但它不是完整世界模型,能力仍受表示维数、数据覆盖和动力学变化限制。FB 学习的是一族策略的 successor measure 的低秩分解,不是单个固定转移矩阵的普通逆矩阵分解。
MBRL
先用真实 transition 监督训练一个预测归一化状态差值的 ensemble 动力学模型,再通过 Random Shooting 或 CEM 在模型中搜索有限时域动作序列,并用 MPC 每次只执行第一步;随着当前策略访问新的状态区域,持续收集真实 on-policy 数据并重训模型。MBPO 分支则不直接用模型在线规划,而是让模型生成短期虚拟数据供 SAC 训练。
在动力学模型中我们直接预测状态差值而非下一状态,把Δ t + 1 = s t + 1 − s t \Delta_{t+1}=s_{t+1}-s_t Δ t + 1 = s t + 1 − s t s ^ t + 1 = s t + Δ ^ t + 1 \hat{s}_{t+1}=s_t+\hat{\Delta}_{t+1} s ^ t + 1 = s t + Δ ^ t + 1 z t z_t z t z ˉ t = z t − μ z σ z + ε \bar z_t=\frac{z_t-\mu_z}{\sigma_z+\varepsilon} z ˉ t = σ z + ε z t − μ z